Google interpose ses propres liens dans les résultats de recherche
Google brouille la piste
Google déploie discrètement un changement important sur son moteur de recherche. Les liens directs dans les résultats sont remplacés par des liens intermédiaires commençant par google.com/goto?. Une « mesure technique » pour se protéger des abus, explique l’entreprise.
Les internautes lambda ne verront pas la différence, mais le changement que Google est en train de déployer sur son moteur de recherche ne passe pas inaperçu chez les spécialistes du SEO. Quand le curseur de la souris survole un résultat, son URL apparait en bas du navigateur. Depuis quelques semaines chez certains internautes, cette information ne renvoie plus directement vers l’URL réelle de la page web, mais affiche une adresse débutant par google.com/goto?. Un clic sur le résultat active ensuite une redirection vers le site désiré.
Un détour entre l’internaute et le web
Avec cette redirection intermédiaire, on perd donc une information importante, celle de l’URL réelle du résultat de recherche. « Nous avons une longue tradition de déploiement de mesures techniques contre des formes d’abus en constante évolution, et nous prenons régulièrement des mesures pour protéger nos services et nos utilisateurs », confirme un porte-parole de Google au site Search Engine Roundtable.
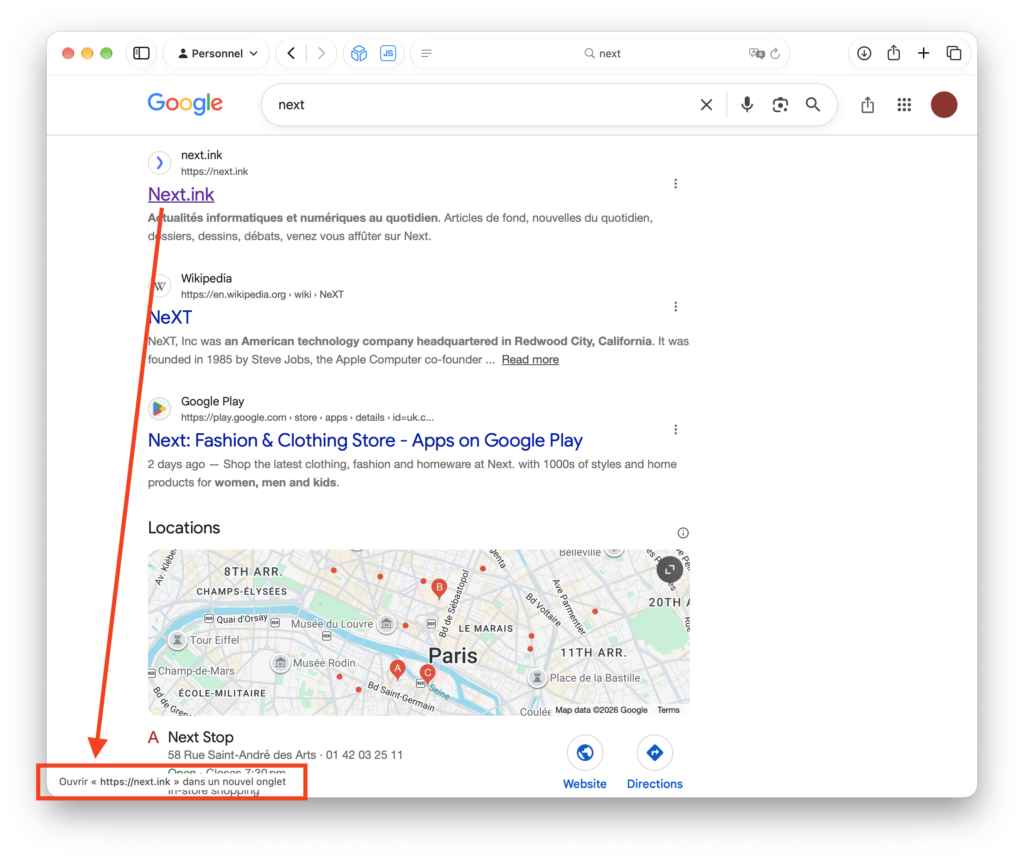
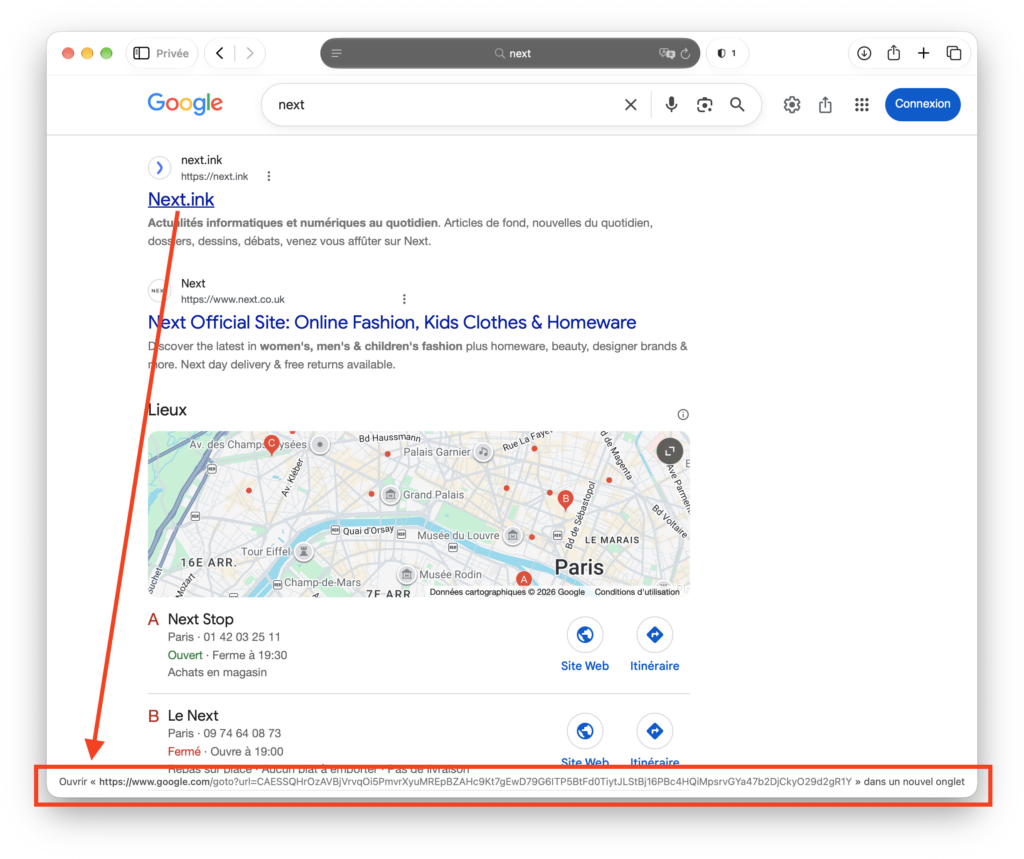
Pour l’utilisateur, ça ne change rien en surface : un clic sur le lien renvoie correctement vers le bon site. Et puis l’URL réelle est toujours présente sous le résultat. En termes de transparence en revanche, il y aurait à redire puisqu’on se retrouve avec des URL différentes pour le même résultat de recherche.
L’impact est bien plus important pour l’écosystème SEO, et pour tous ceux qui pratiquent la mesure d’audience au quotidien. Les outils de suivi de positions, d’analyses des pages de résultats d’un moteur de recherche (SERP) ou d’attribution vont voir des URL de type google.com/goto? au lieu des vraies adresses. Des outils peuvent être amenés à mal classer le trafic, créant une divergence avec Google Search Console.
Si Google est le seul a avoir les moyens de mesurer proprement les résultats, les outils indépendants qui aident les sites à comprendre leur visibilité seront affaiblis. Voilà qui pourrait intéresser les régulateurs voulant briser la domination de Google sur la recherche en ligne.
Google souhaite aussi probablement serrer la vis aux scrapers IA. Les robots qui aspirent automatiquement les résultats Google pour alimenter un moteur de réponse ou pour obtenir à moindre frais des données d’entraînement pour des modèles concurrents pourraient en faire les frais. Le scraping devient plus compliqué avec ces redirections opaques.
Quoi qu’il en soit, ce changement confère à Google un pouvoir accru sur l’accès aux données de recherche. L’entreprise contrôle déjà l’interface, le classement, les impressions, les clics, sa Console, les publicités Ads… Avec une redirection opaque comme c’est le cas ici, Google limite la capacité des chercheurs, des éditeurs et des concurrents à « voir » le web tel qu’il apparait dans le moteur dominant.

Commentaires (12)
Abonnez-vous pour prendre part au débat
Déjà abonné ou lecteur ? Se connecter
Cet article est en accès libre, mais il est le produit d'une rédaction qui ne travaille que pour ses lecteurs, sur un média sans pub et sans tracker. Soutenez le journalisme tech de qualité en vous abonnant.
Accédez en illimité aux articles d'un média expert
Profitez d'au moins 1 To de stockage pour vos sauvegardes
Intégrez la communauté et prenez part aux débats
Partagez des articles premium à vos contacts
Abonnez-vousModifié le 27 août à 15h39
Il doit y avoir une chose que je ne comprends pas. Les liens sont remplacés dans les résultats de recherche Google. Donc le remplacement SEO ne concerne que... Google ! Cela n'impacte pas les liens en général.
[edit] ça y est, j'ai tilté (enfin je crois). Google devait envoyer le lien d'origine avec les query parameters, et donc le site cible avait accès à la recherche qui avait été utilisée.
Le 27 août à 15h44
Modifié le 27 août à 16h23
Le 28 août à 21h52
Le 27 août à 15h45
Le 27 août à 17h39
mieux vaut utiliser Paulgo.io par exemple en instance SearxNG, mais il y en a plein d'autres...
Je constate que ça permet de récupérer les vraies URL et pas celles de Google.
Le 28 août à 10h36
Le 29 août à 20h33
J'ai tenté pendant plus de deux ans de carburer pratiquement qu'à ça...
La plupart d'entre elles, qui récupèrent leurs résultats de goog/bing/qwant/ddgo, finissent rapidement bloquées, au moins un temps..
Résultat : au bout de deux mois, parfois même seulement deux semaines, les recherches ne retournent plus aucun résultat..
Bots, trop d'utilisateurs? Mystères.. mais faut avoir la patience de jongler d'instance en instance régulièrement..
Seule celle de searx.org fournit en général sans pb les résultats des autres moteurs, sans vriament être bloquée.. Pourquoi? Accointance avec google? Mystère... Même le lien "à propos de cette instance" sur searx.org est.. absent. Quand c'est flou, comme on dit..
Rebasculement à duckduckgo ici, sans regret, le temps que la situation des searxs se stabilisent, et je pense qu'il y en a pour longtemps.. De toute façon l'écrasante majorité des sites internet que je consulte, je les connais déjà, j'y vais sans passer par un intermédiaire de recherche..
Modifié le 27 août à 15h54
De plus en plus, c'est des agents qui vont faire les recherches à la place des utilisateurs, sans voir de pub, donc Google va devoir trouver d'autres manières de monetiser la recherche, et ça n'est plus viable de laisser des scrappers vendre leurs résultats aux agents des utilisateurs sur le dos de Google.
Le 28 août à 21h52
Le 27 août à 19h36
Le 28 août à 19h41
Signaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?