Mistral met GLM 5.3 par défaut dans Vibe Code et relance le procès en renoncement
Les chiens aboient, que fait la caravane ?

Mistral AI intègre désormais le modèle d’origine chinoise GLM 5.3 à son assistant dédié au code, et annonce le proposer par défaut dans la version Web de ce dernier. La décision fait réagir de nombreux commentateurs, qui s’interrogent sur la stratégie à long terme de l’entreprise. La discussion qui en découle prend un tour très politique.
Mistral AI persiste et signe. L’entreprise, qui proposait déjà à ses clients d’utiliser le modèle à poids ouvert d’origine chinoise GLM 5.2, a annoncé le 21 septembre dernier une intégration renforcée de la version suivante, GLM 5.3, distribuée à partir de ses propres infrastructures.
« GLM 5.3, hébergé sur Mistral, est maintenant dans Vibe Code, et l’option par défaut dans l’application Web. Fenêtre de contexte [de 1 million de tokens] et limites généreuses incluses », se réjouit Mistral sur X.
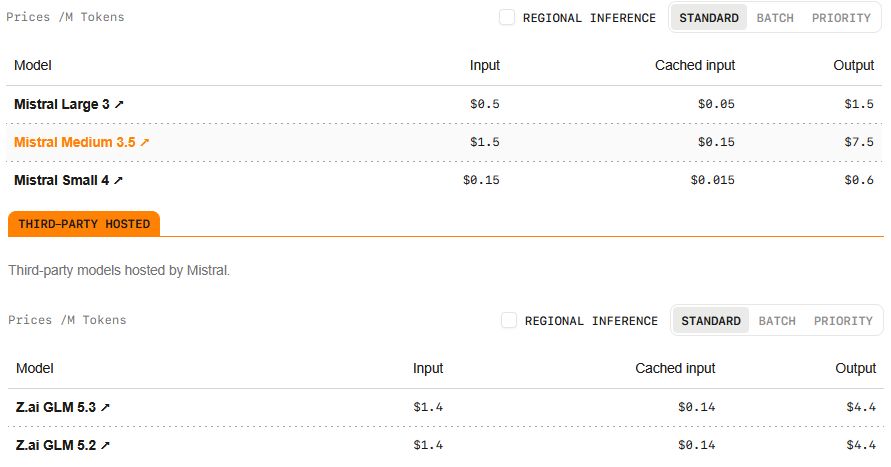
GLM 5.3 moins cher que Mistral Medium 3.5
En réponse à des questions d’internautes, Mistral explique que GLM 5.3 a vocation à devenir le modèle par défaut pour Vibe Code, que ce soit via l’extension VS Code, le client en ligne de commande ou la version Web. « Le mode Work de la version Web va lui aussi passer à GLM 5.3 », précise encore l’entreprise.
Jusqu’ici, Mistral proposait bien les modèles GLM de Z.ai, hébergés par ses soins, comme une alternative à ses propres outils, mais ce sont les modèles généralistes maison, principalement Mistral Medium 3.5 et Mistral Large 3, qui servaient par défaut les requêtes.
En mode API (facturation à l’usage), GLM 5.3 se paie le luxe d’être plus compétitif que les modèles maison. Hors option de type priorité ou inférence régionale garantie, Mistral le facture ainsi 1,4 dollar le million de tokens en entrée, 0,14 dollar pour l’écriture en cache et 4,4 dollars en sortie. En face, Mistral Medium 3.5 est affiché à 1,5 dollar en entrée, 0,15 dollar l’écriture en cache et surtout 7,5 dollars en sortie.
Mistral AI aurait-elle décidé de saborder ses propres modèles ? Sur X, c’est la conclusion à laquelle sautent un certain nombre de commentateurs, qui voient dans cette annonce une forme de renoncement à l’ambition de proposer des modèles frontière développés en propre, et la confirmation d’une bascule stratégique.
Pour ces derniers, Mistral avouerait tacitement ne plus être le champion européen de l’IA tant vanté par les médias et les politiques, mais un simple revendeur d’inférence, doublé d’un intégrateur à la façon d’une entreprise de services numériques. « Mistral est finito et condamné à devenir un Capgemini de l’IA Européenne, c’est triste », résume un anonyme sur X.
Mistral défend l’idée d’une souveraineté via les infrastructures
Si l’annonce liée à GLM 5.3 relance une salve de critiques, la position de Mistral sur le sujet n’est pas nouvelle. L’entreprise parisienne défend en effet de longue date l’idée selon laquelle la souveraineté en matière d’IA n’est pas liée à l’origine du modèle, mais plutôt au contrôle du déploiement de ce dernier et des infrastructures associées. Et c’est justement parce que Mistral a elle-même développé des modèles ouverts de pointe que l’entreprise s’estime bien placée pour mener cette démarche, qui motive ses lourds investissements en infrastructures, notamment en France et en Suède.
Mistral a une nouvelle fois soutenu cette vision dans un billet de blog publié au cœur de l’été, quand elle a commencé à héberger et distribuer GLM 5.2. « Ce modèle ouvert, ainsi que les modèles ouverts futurs, fonctionneront sur la même infrastructure, les mêmes contrôles régionaux et les mêmes engagements de service que les modèles Mistral, permettant ainsi aux clients d’élargir leur choix de modèles sans fragmenter l’emplacement d’exécution de leur IA », écrivait alors l’entreprise.
Cette orientation se justifie donc, selon Mistral, par la nécessité qu’ont ou qu’auront les entreprises de recourir non pas à un unique modèle bon à tout faire, mais à une combinaison de modèles plus spécialisés, comme ceux qu’elle développe en matière d’OCR (reconnaissance de caractère et extraction de documents), de transcription, ou de modération.
Mistral assumait alors son virage vers une stratégie dite de neocloud, c’est-à-dire de mise à disposition de capacités d’inférence. Elle en faisait même l’un des moteurs de son développement, en expliquant que c’était grâce aux engagements d’achats pluriannuels de ses clients qu’elle pourrait former, avec eux, une « coalition pour garantir une capacité de calcul européenne en IA à long terme », avec un objectif fixé à un équivalent de 1 GW de puissance de calcul à horizon 2030.


Commentaires (37)
Le 25 septembre à 09h09
Le 25 septembre à 09h14
Mistral ça marche plutôt bien, en tous cas je n'ai pas vu de gros défaut quand je l'utilises.
Le 25 septembre à 09h16
Le 25 septembre à 09h28
Le 25 septembre à 11h48
Le 25 septembre à 16h55
Le 25 septembre à 17h16
Le 26 septembre à 14h21
Modifié le 26 septembre à 21h25
Le 26 septembre à 22h44
Modifié le 27 septembre à 08h17
(sauf sur des appels API sans system prompt pour conditionner le modèle)
Il n'est donc pas impossible que Mistral conditionne aussi les modèles avec des system prompts pour réduire ces risques. Ce sera à tester.
Le 27 septembre à 10h46
Modifié le 25 septembre à 18h07
Enfin, Mistral n'a pas dit arrêter les modèles souverains.
Le 25 septembre à 10h00
On peut s'imaginer que c'est le modèle évoqué dans l'article, qui a pris un peu de retard. Wait & see !
Le 25 septembre à 10h07
Le 25 septembre à 10h31
Le 25 septembre à 10h36
Le 25 septembre à 14h52
Le 25 septembre à 15h00
Le 26 septembre à 22h35
En ça, ça me rappelle effectivement la stratégie de Qwant : « Alors en fait, le bel index qu'on vous avait promis, ça va être compliqué. Mais merci pour les thunes hein ! ».
Ça reste des spéculations, j'espère me tromper. Mais ce schéma, on l'a vu se répéter un peu trop souvent, dans les commandes de logiciels de l'administration publique, dans l'offre cloud nationale, etc.
Le 25 septembre à 17h46
J'avais entendu cette polémique et je comptais chercher des informations pour me faire une opinion.
Votre article m'aide.
Le 25 septembre à 23h28
Question / idée d'article en passant: A part Mistral on a quoi en Europe au niveaux sociétés d'IA ? Je me souviens avoir lu quelque part d'une société français Arlequin IA (qui vient de faire une levé de fond visiblement) mais je comprend pas vraiment ce qu'ils font. Il y avait aussi une société qui serait le Mistral allemand ( Aleph Alpha ?) mais j'en entend pas du tout parlé. Mais c'est tout ?
Modifié le 26 septembre à 18h09
Les biais seraient différents ?
La sécurité (moins de propension à faire des backdoors sur les logiciels étatiques, comme le font les modèles chinois quand on leur fait pensrr qu'on travaille pour le gouvernement USA, si je me rappelle bien) ?
Modifié le 26 septembre à 18h20
Par contre, en termes de biais, oui ils sont orientés selon les directives de la Chine (ex : parler de Taiwan et compagnie donnera des réponses conformes au discours des autorités). Cela a été régulièrement documenté.
Le 26 septembre à 22h22
Modifié le 27 septembre à 08h14
Par exemple, le chat bot Euria d'Infomaniak repose aussi sur Qwen (ils ont déployé depuis Apertus de Swiss AI en parallèle) et il ne recrache pas la propagande du régime chinois si on lui parle de Taiwan, parce qu'il s'appuie immédiatement sur une recherche Wikipedia. Le system prompt doit donc suffire à le contourner.
Par contre, pour avoir fait le test en API, c'est un bon petit soldat du régime.
L'aspect backdoor et compagnie, j'ai des doutes que ce soit réellement possible puisque l'environnement d'exécution reste maîtrisé par Mistral.
Modifié le 27 septembre à 23h52
Après, en entreprise, on utilise un LLM surtout pour des tâches "fonctionnelles" comme écrire un mail, générer un PPT, résumer une réunion... Je vois assez mal ce que les biais politiques du modèle pourraient avoir comme influence là-dessus de significatif.
À moins que ces modèles soient entraînés pour faire des actes de malveillance dans certaines conditions (par exemple, un prompt français ferait qu'un PPT généré pourrait intégrer une charge malveillante, ou des méta-données particulières), mais ça me semble assez peu probable que ce soit assez fréquent pour être particulièrement problématique (l'exemple donné plus haut semble assez "ciblé").
Modifié le 28 septembre à 07h34
Au-delà des modèles, le risque restera l'utilisation comme toujours. Faire confiance au résultat produit par un LLM et ne pas le faire passer dans une chaîne de sécurité (une chaîne CICD pour du code / avoir un EDR sur les postes utilisateur) est effectivement un risque de voir du code malveillant implémenté sans s'en rendre compte. Sans oublier que la workload aussi doit être sécurisée.
Le 28 septembre à 09h31
Et quand ça entre en production ça demande 1.2x plus de serveur qu'un équivalent chinois ou autre. C'est discret mais ça augmente les couts
Modifié le 27 septembre à 16h48
À titre d'information complémentaire, les produits Mistral sont actuellement déployés dans l'éducation nationale (Assistant IA) et dans Nuage, le Nextcloud souverain de l'éducation nationale, il y a pas mal de piste d'amélioration mais ça marche plutôt bien.
Le 27 septembre à 15h06
Perso j'appelle ça des idiots utiles.
Le 27 septembre à 15h26
Le 27 septembre à 15h45
Le 27 septembre à 16h50
Le 27 septembre à 17h37
Le 28 septembre à 14h07
Le 28 septembre à 16h10
Signaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?