En Europe, OpenAI tatoue les textes de ChatGPT pour se conformer à l’AI Act
Si c'est tatoué, c'est pas à toi
OpenAI déploie son outil de filigrane sur le texte généré par ChatGPT. Cette fonctionnalité, réservée au Vieux continent en vertu de l’AI Act, demeure une solution imparfaite à un problème complexe.
Après Anthropic qui a intégré une fonction de filigrane dans le texte généré par Claude (depuis Fable 5.1 plus précisément), c’est au tour d’OpenAI de respecter l’obligation européenne de permettre l’identification d’un texte généré par ChatGPT. Cette mesure, inscrite dans l’AI Act, est en vigueur depuis début août – les systèmes d’IA présents sur le marché ont jusqu’au 2 décembre pour respecter les obligations de marquage technique.
Le filigrane est dans les mots
OpenAI a donc dévoilé sa feuille de route pour le tatouage des textes. La technologie, baptisée textGrain, ajoute un « signal statistique invisible » sur les choix des mots. Autrement dit, c’est une technique qui « modifie subtilement la manière dont le modèle choisit de façon aléatoire entre plusieurs mots ou fragments de mots possibles au fil de la génération [du texte] », explicite l’entreprise dans une fiche technique.
« Sur l’ensemble d’un passage, ces choix créent un motif qu’un détecteur peut repérer, même après certaines modifications du texte. » Le résultat est censé être invisible aux yeux du lecteur, la technique n’ajoutant « aucun caractère caché, espace invisible ou signe de ponctuation inhabituel ». Anthropic a choisi une solution similaire.
Pangram, qui a beaucoup fait parler ces dernières semaines suite à l’affaire Thélyson Orélien, analyse les textes après leur génération, en se basant sur des caractéristiques comme le choix des mots. Il ne détecte pas les signaux intégrés à même les textes, comme c’est le cas des filigranes.
- On a soumis plus de 5 000 textes à 75 détecteurs d’IA gratuits : un constat d’échec
- Pangram sait-il vraiment détecter les textes IA ? Notre test sur plus de 1 000 articles
Toutes les langues ne se valent pas
Le code des bonnes pratiques sur la transparence des contenus de l’AI Act n’impose pas de watermark sur les textes de moins de 200 tokens, ce qui représente environ 150 mots en anglais. De toute manière, les techniques de filigrane ne sont pas efficaces sur les textes courts, comme le rappelle OpenAI.
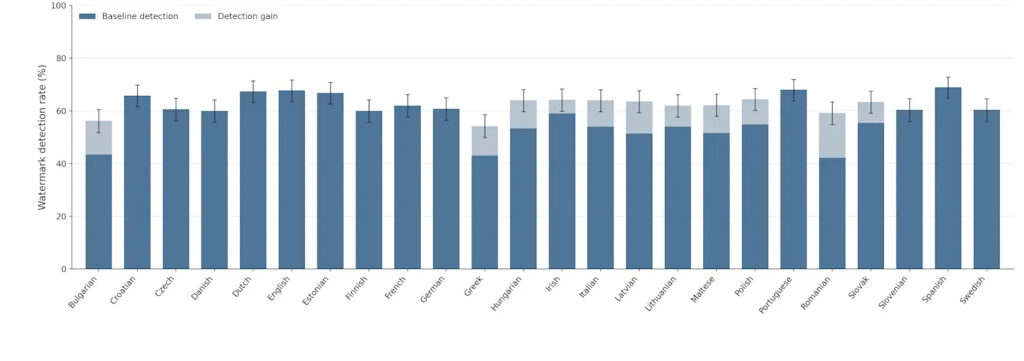
Le taux de détection varie en fonction de la langue, certaines d’entre elles se montrant « plus faciles à détecter que d’autres ». Sur les tests réalisés par l’entreprise – 500 prompts générés en anglais, puis traduits –, l’espagnol obtient le meilleur taux de détection (69 %), le roumain affichant le taux le plus faible (42,2 %). Avec un taux qui dépasse 60 %, le français est plus proche de l’espagnol.
OpenAI ajoute à textGrain un paramètre d’ajustement de l’intensité pour renforcer ou réduire le signal du filigrane en fonction des domaines. Le taux de détection de certaines langues, qui se situe normalement sous le seuil des 60 %, s’améliore grâce à ce paramètre. L’entreprise a l’intention de proposer sa technologie en open source.
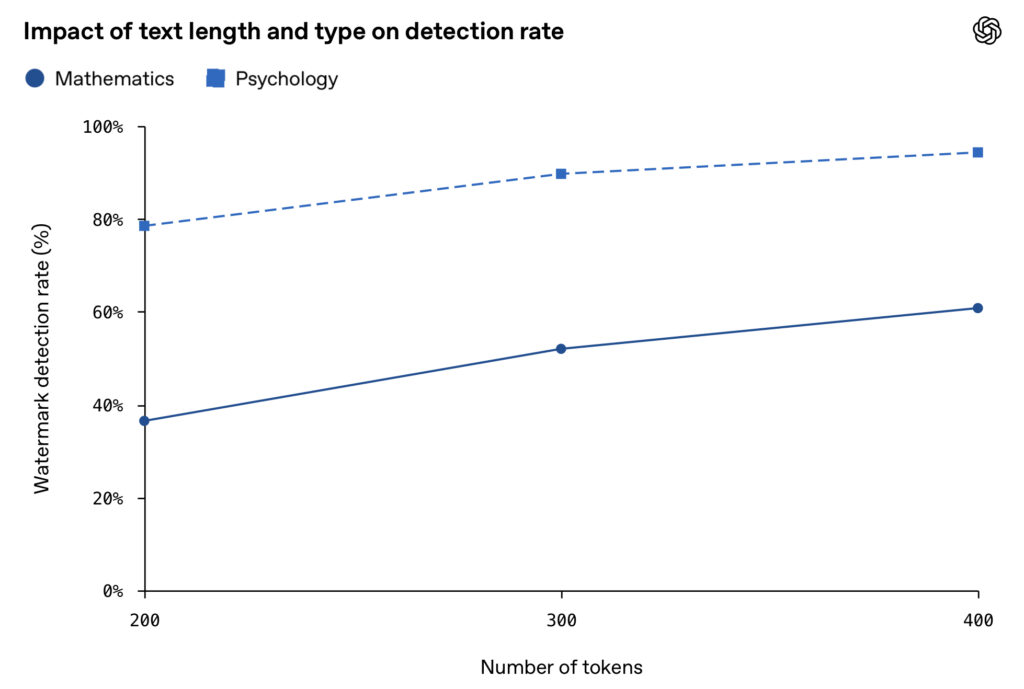
OpenAI explique que les détecteurs peuvent commettre deux types d’erreurs de détection : faux positifs (signaler la présence d’un filigrane qui n’existe pas) et faux négatifs (ne pas repérer la présence d’un filigrane existant). Sur des passages de 400 tokens, avec un taux de faux positifs cible de 1 %, le détecteur a identifié un filigrane dans 95 % des cas – mais tout dépend du contenu. Sur les textes portant sur la psychologie, le taux de détection est particulièrement élevé ; il l’est beaucoup moins quand il s’agit de mathématiques, où le choix des mots est plus limité.
Brouiller les pistes
Autre limite : modifier les textes générés par IA a un impact sur le taux de détection. Un taux de détection à 92 % peut tomber à 66 % si 10 % des mots ont été remplacés par des synonymes. Remplacer 25 % des mots fait chuter le taux à 17 %. Ce qui est logique, au vu du fonctionnement du filigrane.
L’entreprise prévient aussi que les filigranes sur le texte ne sont pas la panacée. Un watermark ne mesure pas la contribution d’un humain, il se contente de dire qu’un modèle a généré ou modifié un texte. Il ne détermine pas non plus à qui appartient le texte ou qui en est le responsable. Il n’identifie pas non plus l’utilisateur et ne mesure pas la fiabilité du texte. Enfin, l’absence d’un filigrane ne prouve pas qu’un texte a été écrit par un humain.
textGrain est disponible dès aujourd’hui dans l’API, où la fonction peut être activée via les réglages (uniquement dans l’UE). Il se déploiera au sein de ChatGPT et Codex dans les prochaines semaines. En revanche, l’accès à l’outil de détection demeure encore la chasse gardée des chercheurs et des organisations sélectionnés qui travaillent à l’amélioration de la fiabilité de l’outil.
Commentaires (4)
Abonnez-vous pour prendre part au débat
Déjà abonné ou lecteur ? Se connecter
Cet article est en accès libre, mais il est le produit d'une rédaction qui ne travaille que pour ses lecteurs, sur un média sans pub et sans tracker. Soutenez le journalisme tech de qualité en vous abonnant.
Accédez en illimité aux articles d'un média expert
Profitez d'au moins 1 To de stockage pour vos sauvegardes
Intégrez la communauté et prenez part aux débats
Partagez des articles premium à vos contacts
Abonnez-vousIl y a 41 minutes
Modifié il y a 35 minutes
Mais j'adore le sous-titre original, en tous cas ! 😁
Il y a 11 minutes
Le monde va bien.
À l'instant
Signaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?