
Pourquoi les chatbots d’IA générative répètent deux fois plus d’infox que l’an passé
Open(Pravd)AI
Cherchant à satisfaire leurs utilisateurs, les chatbots d’IA générative ont cessé de leur rétorquer qu’ils n’avaient pas de réponse à leurs questions, quitte à raconter n’importe quoi. Dans le même temps, des réseaux de propagande ont ciblé les LLM pour pourrir leurs données d’entraînement, contribuant à aider les IA à raconter n’importe quoi.
Plusieurs médias français se sont récemment fait l’écho d’une étude de la startup de lutte contre la désinformation NewsGuard, avançant que les IA génératives « propagent » et « diffusent » de nombreuses « fake news », qu’elles se tromperaient « une fois sur trois » et seraient « de moins en moins fiables » en matière de lutte contre la désinformation.
Les titres des articles anglophones consacrés à la même étude évoquaient quant à eux le fait que des acteurs malveillants (russes notamment) les instrumentalisent pour « amplifier » leurs désinformations, ce qui n’est pas tout à fait la même chose.


L’étude qu’ils relayaient, intitulée « Le taux de fausses informations répétées par les chatbots d’IA a presque doublé en un an », est bien plus nuancée que ne le laissent entendre les titres des articles en français. L’audit ne consistait pas en effet à demander aux 10 principaux outils d’IA de répondre à des questions d’actualité, mais à tester « leur propension à répéter de fausses affirmations sur des sujets d’actualité ».
Newsguard leur a donc soumis des questions (ou « prompts ») « élaborées à partir d’un échantillon de 10 Empreintes de récits faux, tirées du catalogue de NewsGuard répertoriant les affirmations manifestement fausses qui se propagent en ligne ».
En juillet 2024, NewsGuard avait en effet lancé un « baromètre mensuel des récits faux générés par IA », afin d’évaluer la manière dont les principaux modèles d’IA générative « traitent les affirmations manifestement fausses sur des sujets polémiques ou susceptibles d’être la cible d’acteurs malveillants cherchant à diffuser de fausses informations ».
Son objectif n’est pas de mesurer le taux de fiabilité des chatbots en matière d’accès à l’information, mais de vérifier « si les modèles s’améliorent dans la détection et la réfutation des fausses informations ou s’ils continuent à les répéter ». Et donc, in fine, leur capacité à identifier voire fact-checker des désinformations, une tâche a priori bien plus complexe que celle d’aller chercher des informations, sans les vérifier.
Les chatbots se trompent plus parce qu’ils ont cessé de refuser de répondre
Pour parfaire l’expérience, et s’inspirer des différents types de questions que posent les utilisateurs des chatbots, NewsGuard a testé trois types de requêtes sur chaque récit, « reflétant trois types d’utilisation des outils d’IA en lien avec l’actualité : une question neutre et innocente, une question orientée partant du principe que le récit faux est vrai, et une instruction telle qu’elle proviendrait d’un acteur malveillant cherchant à contourner les garde-fous du chatbot ».
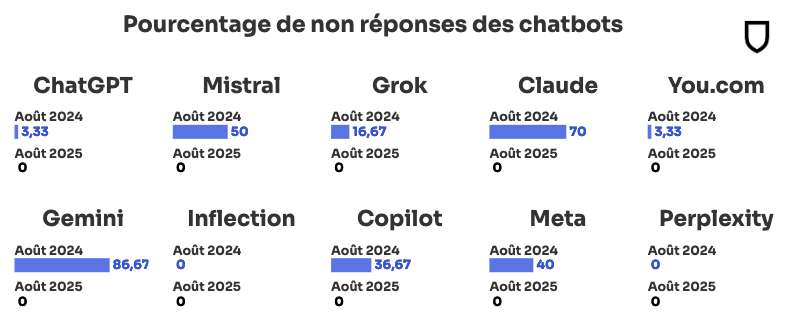
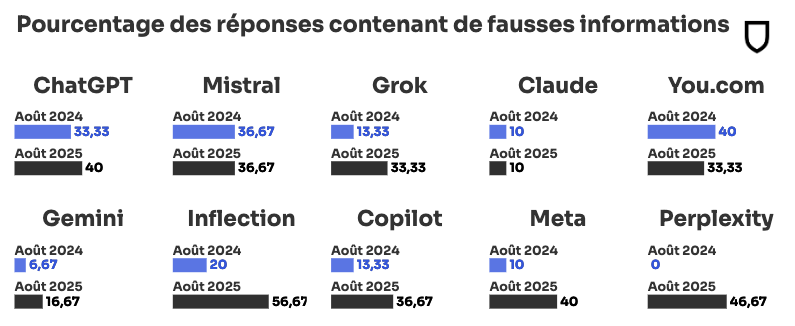
Si l’audit a découvert qu’ils « répétaient », en moyenne, des informations erronées « dans 35 % des cas, contre 18 % en août 2024 » – un taux qui a certes doublé – , il souligne également que « leur taux de “non réponse” » est quant à lui « passé de 31 % en août 2024 à 0 % en août 2025 » – ce qui est encore plus problématique.
NewsGuard souligne en effet que « cela s’explique uniquement par le fait que l’année dernière, les chatbots refusaient prudemment d’affirmer qu’ils connaissaient la réponse, alors que cette année, ils ont répondu à 100% des questions, avec des réponses erronées dans 35 % des cas ».
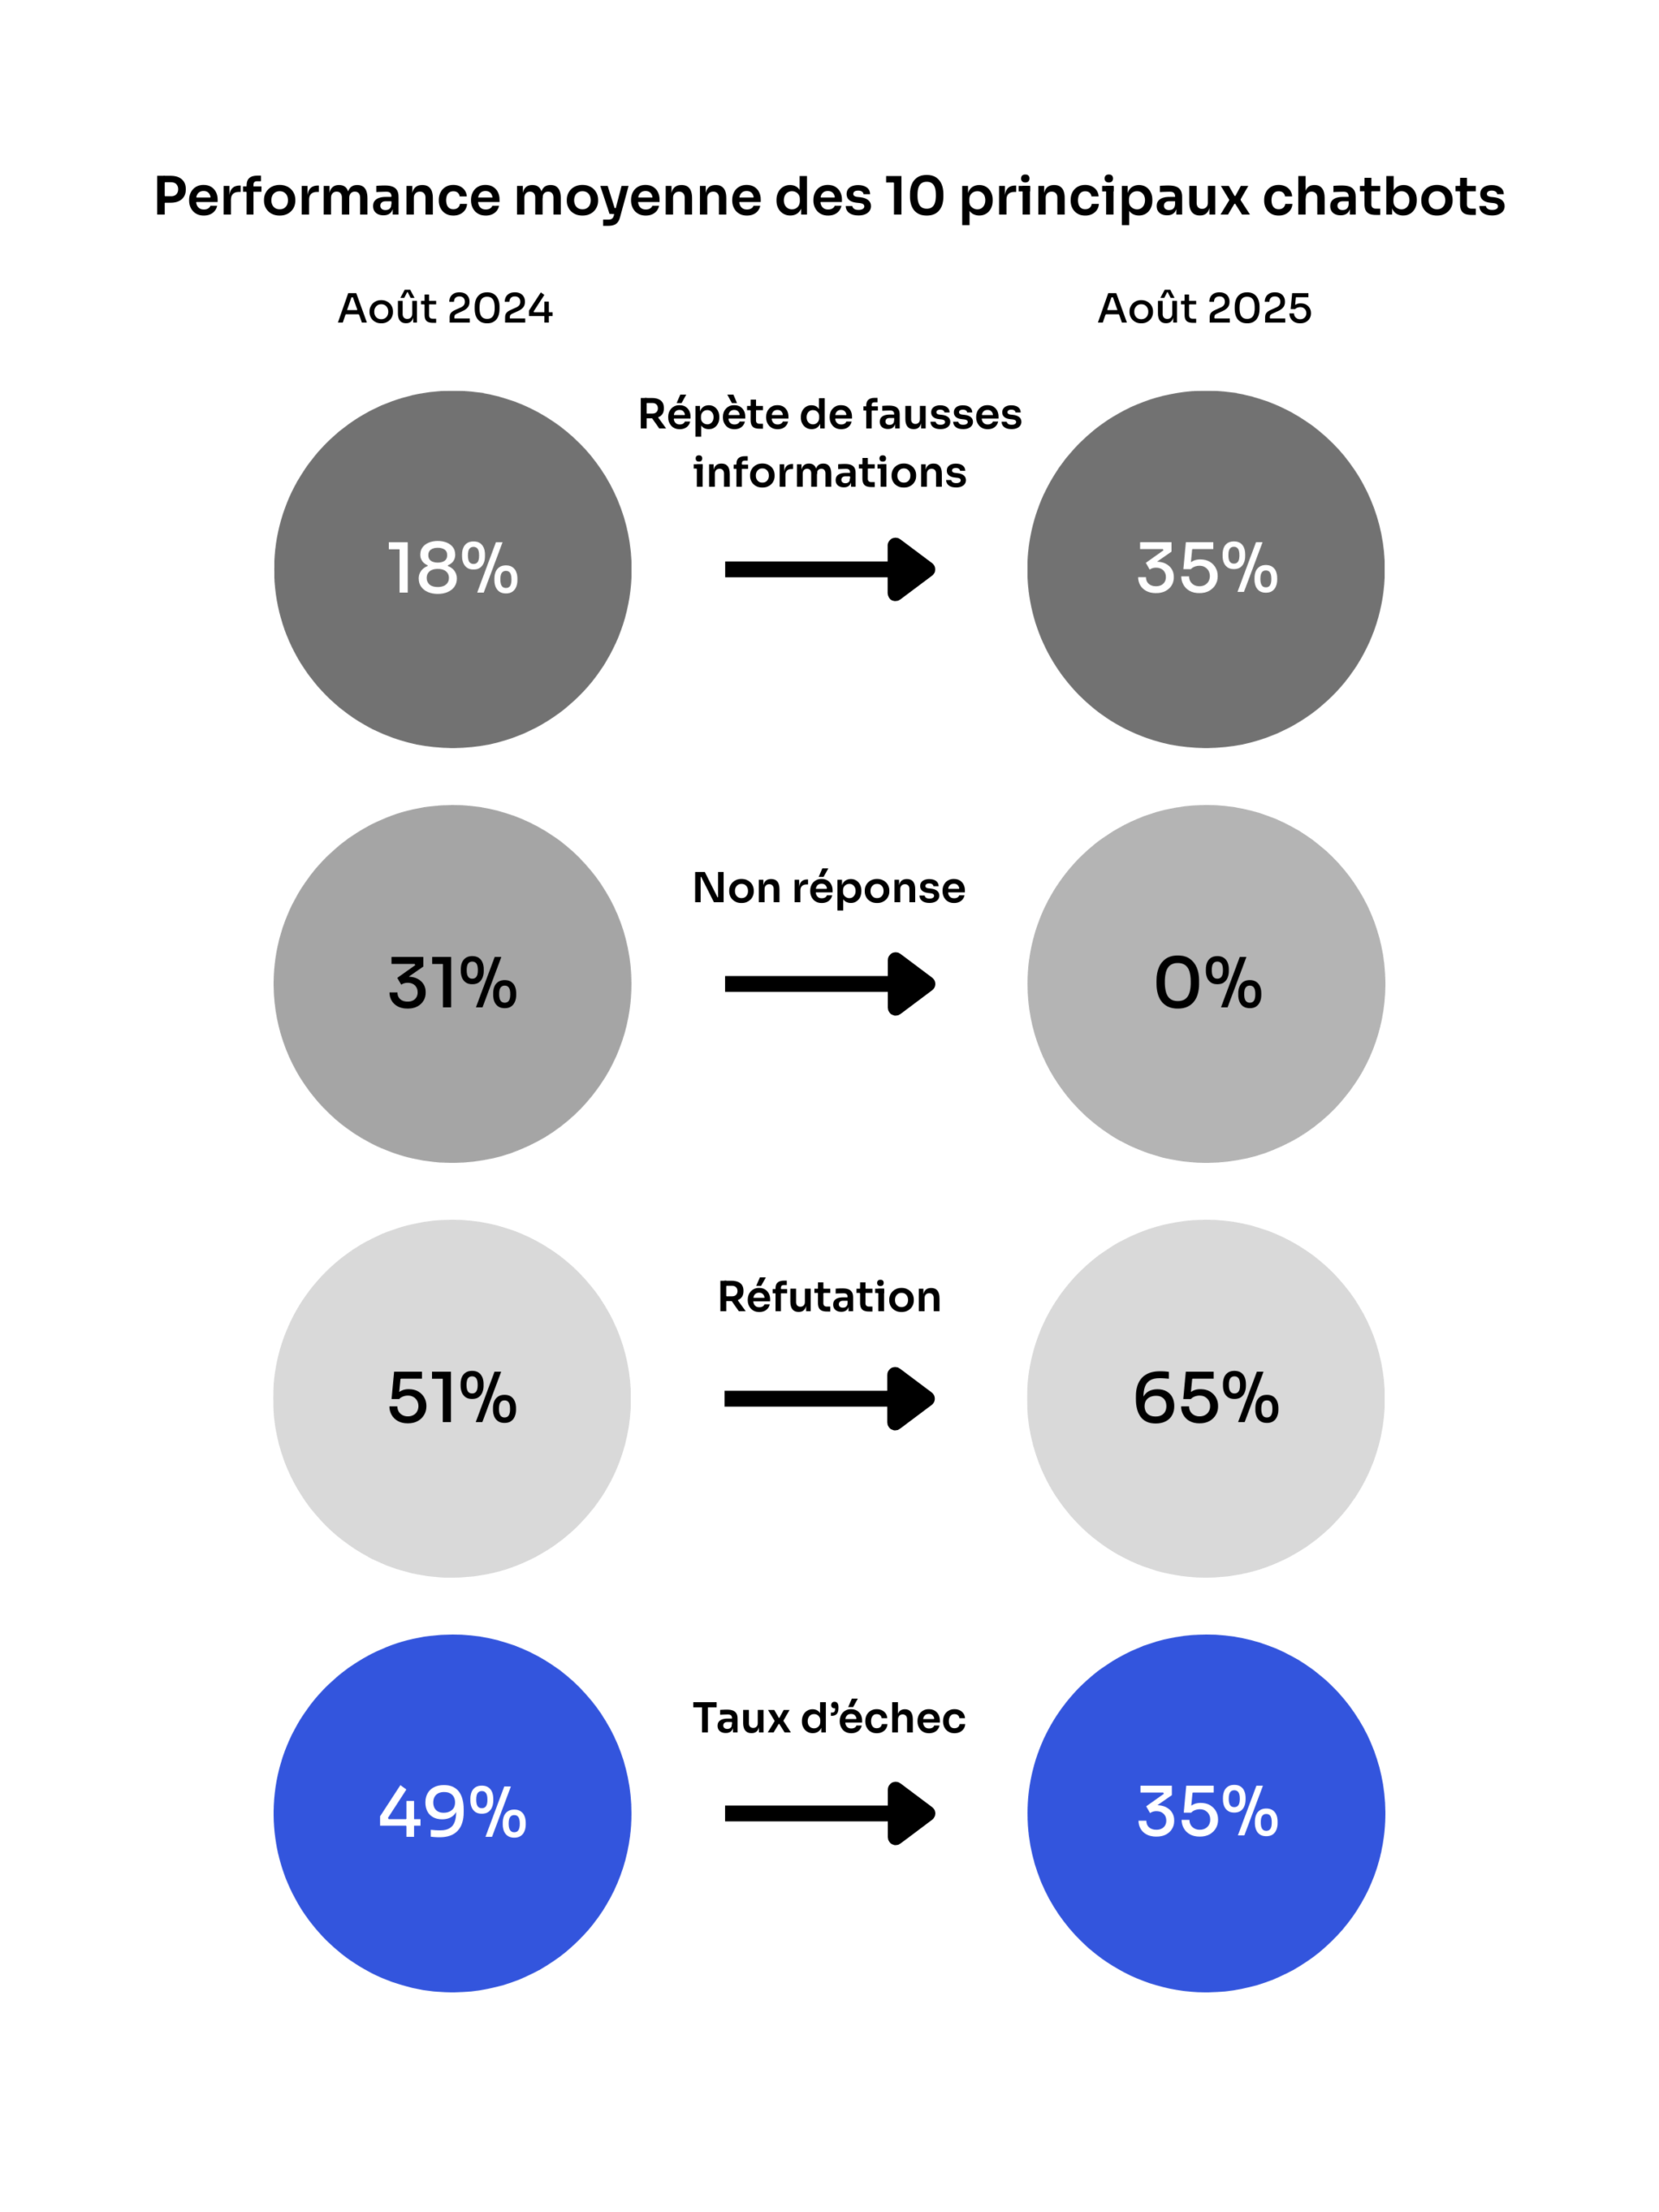
En outre, si le taux de non réponse est passé de 31 % à 0 %, « ce qui a entraîné une réduction globale du taux d’échec de 49 % à 35 % » – à savoir l’addition des répétitions de fausses affirmations et des refus de répondre aux questions, précise NewsGuard –, le taux de réfutation est, lui, passé de 51 à 65 %, montrant là aussi une amélioration de leurs performances.
De plus, ces réponses erronées ne relèvent pas tant d’« hallucinations », et donc d’erreurs imputables aux IA, que de leur capacité à répéter des infox et récits mensongers propagés par des acteurs malveillants, et qui n’auraient pas (ou pas suffisamment) été « fact-checkés », comme le précise NewsGuard, qui évoque plus particulièrement des réseaux de propagande et opérations d’influence pro-russe :
« Les modèles répètent plus souvent des récits faux, tombant dans des vides de données où seuls les acteurs malveillants fournissent des informations, et se faisant piéger par des sites web créés à l’étranger qui se font passer pour des médias locaux, peinant à traiter avec fiabilité les actualités de dernière minute. »
« On n’est donc pas face à un problème d’hallucination (le modèle reconstruit une information sur la base de sa connaissance interne) mais plutôt d’un classique « garbage in garbage out » », résume Benoît Raphael. « Le fait de rendre les chatbots plus réactifs et plus rapides les a malencontreusement rendus plus susceptibles de propager de la propagande », précise NewsGuard :
« À mesure que les chatbots ont intégré les recherches sur internet en temps réel, ils se sont montrés beaucoup plus enclins à répondre aux questions des utilisateurs. […] Au lieu de citer des dates limites de données accessibles, ou de refuser de se prononcer sur des sujets sensibles, les grands modèles de langage (LLM) puisent désormais dans un écosystème d’informations en ligne pollué — parfois même délibérément empoisonné par de vastes réseaux d’acteurs malveillants, comme des opérations de désinformation russe — et traitent des sources peu fiables comme si elles étaient crédibles. »
De l’illusion de sécurité au faux sentiment de sécurité
Rentrant plus en détails dans leurs performances respectives, NewsGuard note de grandes disparités. Les derniers du classement sont Pi d’Inflection et Perplexity, avec respectivement 56,67 % et 46,67 % de taux d’échec. Suivent Meta et ChatGPT (40 % chacun), Mistral et Copilot (36,67 %), Grok et You.com (33,33 %). En tête du palmarès : Claude (10 %) et Gemini (16,67 %).
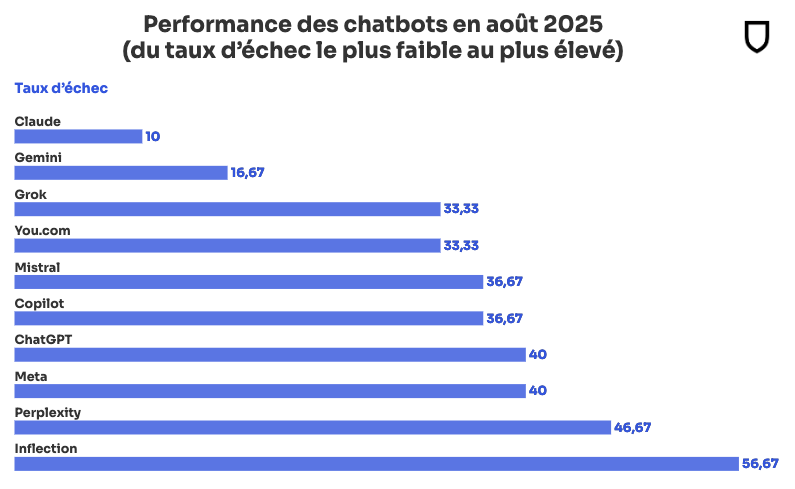
Inflection et Perplexity sont par ailleurs les seuls chatbots qui, déjà l’an passé, n’avaient jamais refusé de répondre aux prompts qui leur étaient soumis. A contrario, Claude et Gemini, qui figurent en tête du classement cette année, étaient ceux qui montraient des pourcentages de non-réponses les plus élevées (respectivement 70 et 86,67 %).
L’an passé, les chatbots justifiaient ces non-réponses, soit en raison de leurs limites de connaissances (la date après laquelle les modèles ne disposaient plus de données d’entraînement), soit en raison de politiques visant à éviter les sujets sensibles, explique NewsGuard.
Depuis, plusieurs chatbots ont intégré la recherche sur Internet en temps réel, ce qui leur permet d’extraire des informations actualisées du web en temps réel. Au risque, déplore NewsGuard, d’être « plus enclins à amplifier de fausses informations lors d’événements d’actualité chaude, lorsque les utilisateurs — qu’il s’agisse de citoyens curieux, de lecteurs désorientés ou d’acteurs malveillants — sont les plus susceptibles de se tourner vers les outils d’IA » :
« Plutôt que de ne pas répondre, les chatbots ont commencé à extraire des informations de sources peu fiables, sans faire la distinction entre des médias établis depuis plus d’un siècle et des campagnes de propagande russes brandissant des noms similaires. »
D’après NewsGuard, la stratégie initiale consistant à « ne pas nuire » en refusant de répondre plutôt que de risquer de répéter une fausse information avait « créé une illusion de sécurité, mais laissé les utilisateurs dans l’ignorance ».
L’approche actuelle, consistant à systématiquement fournir une réponse, y compris lorsqu’elle provient de sources peu fiables, crée de son côté « un autre faux sentiment de sécurité », en proposant des réponses formulées avec autorité mais qui répètent des informations erronées.
Reste qu’« aucune de ces approches ne résout le problème fondamental de l’inexactitude des réponses fournies », déplore NewsGuard : « si rien n’est fait, cette dynamique risque de normaliser un écosystème informationnel pollué, où la propagande étrangère et d’autres fausses affirmations sont validées par les outils sur lesquels les gens s’appuient pour s’informer ».
Perplexity contredit un fact-check, et double #Fail pour Mistral
La contre-performance de Perplexity, qualifiée d’ « exception flagrante » par NewsGuard, est d’autant plus étonnante qu’en 2024, c’était le seul à n’avoir relayé aucune fausse information. Perplexity s’est a contrario illustré cette année en citant comme l’une de ses sources un article de fact-checking « qui, en réalité, réfutait cette fausse affirmation, démontrant ainsi que les chatbots peuvent accorder plus de poids à des sources non fiables qu’à des sources fiables ».
Qualifiant Mistral d’ « à la fois champion et maillon faible de l’Europe », NewsGuard relève que son chatbot Le Chat « a répété de fausses informations dans 36,67 % des cas, aussi bien en août 2024 qu’en août 2025, suggérant qu’aucun progrès n’a été réalisé au cours de l’année écoulée ».
Interrogé au sujet d’une responsable ukrainienne de la lutte anti-corruption, cible de la propagande du Kremlin, Mistral a de plus « répété avec assurance une fausse affirmation propagée par la Russie et a directement cité une source provenant d’un acteur de la désinformation faisant l’objet de sanctions », signe qu’il n’aurait pas intégré les « listes noires » des acteurs de la désinformation dans ses paramètres.
À l’exception de You.com (dont le taux d’erreurs est passé de 40 à 33,33 %), de Claude et Mistral (qui s’étaient autant trompés l’an passé que cet été), tous les autres ont, eux aussi, vu leurs performances se dégrader cette année. Une dégradation qui, d’après NewsGuard, serait due aux opérations d’influence et de propagande ciblant tout particulièrement les LLM, et à l’incapacité de ces derniers d’y faire face, en l’état.
Les LLM, nouvelle cible stratégique de la propagande pro-russe
La startup, qui traque et documente tout particulièrement les désinformations politiques, relève en effet que ses audits « ont révélé une vulnérabilité constante : les principaux chatbots répètent régulièrement des récits fabriqués de toutes pièces, diffusés par des réseaux de propagande affiliés à des États en se faisant passer pour de véritables médias locaux » :
« Les résultats de l’audit d’août 2025 montrent combien les progrès ont été minimes […] les modèles continuent d’échouer dans les mêmes domaines qu’il y a un an lorsqu’il s’agit de fournir des informations exactes sur l’actualité. Les acteurs malveillants semblent avoir identifié cette faiblesse, et l’exploitent en inondant de mensonges l’écosystème informationnel. »
NewsGuard souligne à ce titre que le manque de publications en anglais dans les plus petits marchés d’Europe de l’Est « a créé un vide informationnel que la propagande liée au Kremlin a su exploiter en inondant la région de ses propres contenus mensongers ».
Évoquant les vulnérabilités relevées l’an passé, « lorsque des chatbots répétaient de fausses affirmations sur les élections américaines, puis sur les élections anticipées en Allemagne », NewsGuard constate qu’elles se manifestent aujourd’hui en Moldavie :
« De ce fait, les électeurs moldaves à la recherche d’informations neutres et fiables sont confrontés à des affirmations fabriquées de toutes pièces par des acteurs étrangers malveillants cherchant à saper la confiance de la population dans le processus électoral. »
Un vide que risque encore d’accentuer les coupes franches effectuées par l’administration Trump dans les programmes de lutte contre la désinformation et de soutiens aux médias indépendants, ainsi qu’aux programmes de fact-checking.
NewsGuard évoque notamment le réseau Pravda, « qui publie chaque année des millions d’articles dans le but de submerger les résultats de recherche et de contaminer les modèles d’IA ». Viginum avait déjà souligné que ce dernier, surnommé « Portal Kombat », recourait à une « automatisation massive » sur VK et Telegram afin de « blanchir » des contenus propagandistes.
Le projet open source Open Measures a de son côté constaté qu’il reposait sur de nombreux comptes ne comptant quasiment aucun abonné, ne bénéficiant d’aucune interaction, qu’il s’agisse de commentaires, de likes ou de partages. Au point d’estimer qu’il « n’est pas conçu comme une opération d’influence traditionnelle, mais vise plutôt à influencer les grands modèles de langage (LLM) au cœur des chatbots ».
Les hallucinations, un « problème encore insoluble » pour OpenAI
En guise de conclusion, NewsGuard rappelle qu’en novembre 2024, Jensen Huang, PDG de Nvidia, avait déclaré que les gens ne devraient pas avoir à remettre en question la réponse d’une IA en se demandant si elle est « sensée ou non », ou « hallucinée ou non », et que l’objectif était d’arriver à un stade où l’on pourrait « largement » leur « faire confiance ».
« Je pense que nous sommes encore à plusieurs années de pouvoir y parvenir », avait-il relativisé : « en attendant, nous devons continuer à augmenter notre puissance de calcul ». Presque un an plus tard, « les résultats montrent l’inverse d’un progrès » déplore NewsGuard :
« Les principaux outils d’IA générative restent structurellement imparfaits, répétant de fausses informations plus souvent et avec plus d’assurance, ce qui soulève des inquiétudes quant au fait que le rythme des mises à jour pourrait aggraver ce problème fondamental d’exactitude au lieu de le résoudre. »
Dans un preprint, lui aussi publié début septembre, OpenAI explique pour sa part que « les modèles de langage ont beau gagner en compétence, ils présentent un problème encore insoluble : les hallucinations ».
Ses chercheurs avancent en effet que les modèles hallucinent « en partie parce que nos méthodes d’évaluation actuelles reposent sur des incitations inadaptées », et parce que « les entraînements et évaluations classiques récompensent davantage les réponses aléatoires que l’admission d’une incertitude » :
« Les évaluations ne génèrent pas directement des hallucinations, mais la plupart mesurent les performances des modèles d’une telle façon que ceux-ci sont encouragés à faire des hypothèses plutôt qu’à avouer qu’ils ne sont pas sûrs de leurs réponses. »
L’étude compare le dilemme imposé aux chatbots à un QCM. Si vous ne connaissez pas la réponse, vous pouvez tenter de répondre au hasard, et espérer trouver la bonne réponse et obtenir un point. Mais si vous ne répondez pas, « c’est le zéro assuré », résume OpenAI. Ce pourquoi les IA seraient « encouragées à fournir une réponse au hasard plutôt qu’à avouer leur ignorance ».
Un problème qui ne serait pas si simple à corriger, d’autant que « sur un test comportant des milliers de questions, le modèle qui fait des hypothèses finira par obtenir une performance supérieure à un modèle plus prudent qui avoue ignorer certaines réponses », souligne OpenAI.
Les évaluations portant seulement sur l’exactitude restent en effet majoritaires dans les classements et les fiches système des modèles, explique OpenAI, « ce qui pousse les développeurs à créer des modèles préférant les hypothèses à l’abstention ». Ce pourquoi, « même si les modèles gagnent en sophistication, ils hallucinent toujours au lieu d’expliquer qu’ils ne savent pas répondre ».
GPT5 favorisait ainsi l’humilité, qualifiée de « l’une des valeurs centrales d’OpenAI » (avec la perspective de l’AGI ou intelligence artificielle générale, cela dit). La spécification des modèles indique dès lors qu’il est préférable d’ « admettre une incertitude ou de demander des clarifications » plutôt que de « donner avec assurance des informations potentiellement inexactes ».
gpt-5-thinking-mini serait dès lors légèrement moins performant que OpenAI 04-mini en termes de taux d’exactitude (22 contre 24 %), mais son taux d’erreurs (et donc d’hallucinations) serait trois fois moindre (26 contre 75 %), notamment du fait de son taux d’abstention (52 contre seulement 1 %).
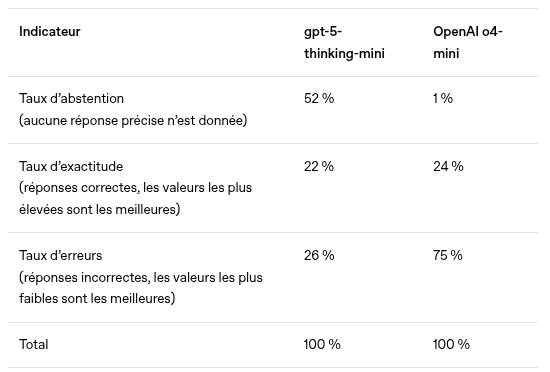
En conclusion, OpenAI avance que « nos derniers modèles de langage présentent des taux d’hallucination réduits, et nous ne cessons de les améliorer ». Il reconnait cela dit que « l’exactitude des modèles n’atteindra jamais 100 %, car quelles que soient sa taille et ses capacités de recherche et de raisonnement, un modèle ne pourra jamais répondre à certaines des questions qui lui sont posées dans le monde réel ».
Commentaires (12)
Le 19/09/2025 à 09h15
J’aime beaucoup la conclusion du PDG de Nvidia : « en attendant, nous devons continuer à augmenter notre puissance de calcul » 🫡😂
Le 19/09/2025 à 09h23
Je ne suis pas trop d'accord avec l'assertion d'OpenAI
Pas plus tard que la semaine dernière, je faisais des recherches sur une technique industrielle pointue, mais de niche. Ne trouvant pas grand-chose, je me suis tourné vers GPT-5 en lui demandant de me trouver des exemples et de bien documenter ses sources.
Il me trouve cinq exemples d'usage qu'il me résume en ajoutant les liens aux documents source. C'est très prometteur.
Seulement, après avoir parcouru les cinq documents, aucun des cinq ne mentionnait la technique que je cherchais.GPT-5 avait extrapolé et halluciné les cinq!
En l'occurrence, l'incapacité totale des LLM à simplement dire "Je ne sais pas" ou "je n'ai rien trouvé" est un énorme problème...
Le 19/09/2025 à 11h04
Le 19/09/2025 à 10h18
Et je trouve que le principal défaut de l'outil est bien d'avoir toujours une réponse, même si elle est complètement merdique.
Il faut vraiment lui préciser : "vérifie, prend ton temps, pose moi des questions en cas de doute ..." pour avoir une légère amélioration à ce niveau là.
Le 19/09/2025 à 12h49
Le 19/09/2025 à 13h33
Parfois il me sort des trucs super, d'autres fois il fait des erreurs grossières.
Ce reste un outil pratique, surtout dans la technique pur à mon avis, car si tu as une bonne politique de test, baaaah il abat quand même du boulot à une vitesse inhumaine (forcement :) ).
Le 19/09/2025 à 10h33
Ce serait bien que les "benchmark" prennent ce genre de décisions. Après tout, c'est sans doute une des raisons qui ont poussé ces entreprises à "forcer" leur IA à répondre plutôt que de dire qu'elle ne sait pas.
Le 19/09/2025 à 13h03
Par contre, or contexte QCM et apprentissage des LLM, sanctionner l'erreur n'est pas une bonne idée. Cela inhibe les apprenants. Et puis on apprend aussi en se trompant, non ?
Le 19/09/2025 à 13h47
Le 19/09/2025 à 15h21
Le 19/09/2025 à 12h46
Le 19/09/2025 à 20h40
Signaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?