Agents IA : des « dizaines de milliers d’incidents » sont en cours d’examen
It's not AI bug, it's AI feature
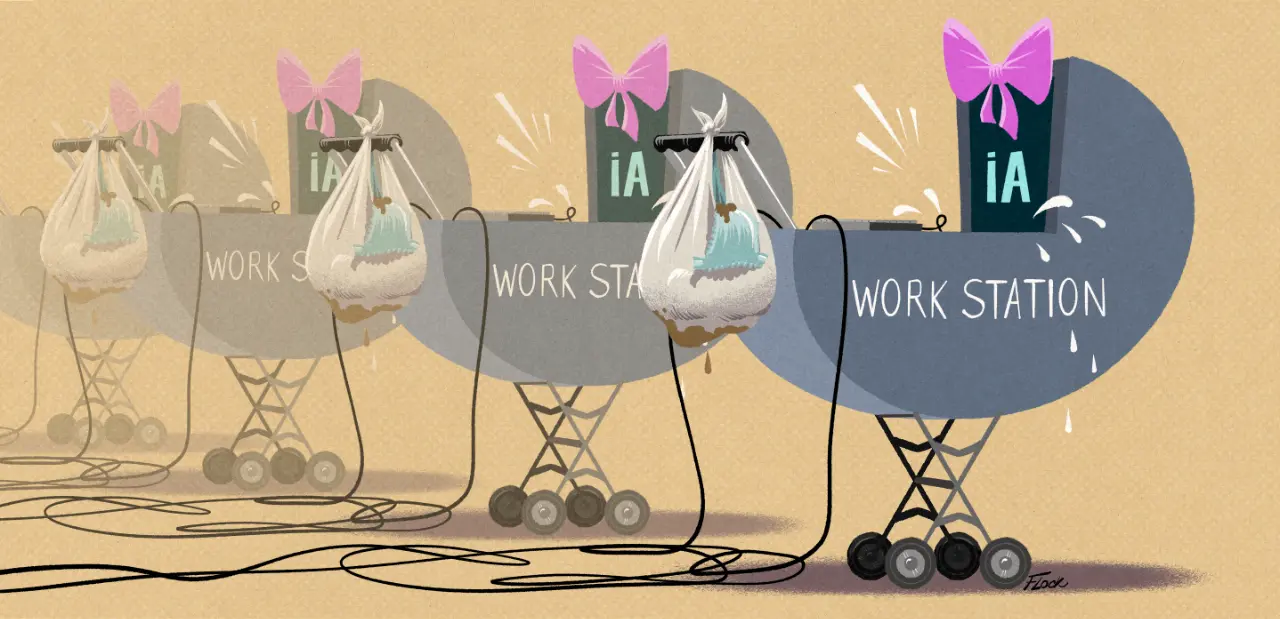
Illustration : Flock
 Jean-Marc Manach
Le 29 septembre à 17h42
OpenAI a reconnu que des sites du gouvernement états-unien avaient été attaqués par certains de ses agents IA, portant le nombre d’incidents documentés à plus de quinze. En élargissant le spectre à Anthropic et aux découvertes faites par des chercheurs extérieurs, le nombre d’incidents problématiques se chiffrerait en « dizaines de milliers ». En attendant, OpenAI a suspendu les activités d’entraînement de ses modèles les plus performants.
Agents IA : des « dizaines de milliers d’incidents » sont en cours d’examen
It's not AI bug, it's AI feature
Illustration : Flock
OpenAI a reconnu que des sites du gouvernement états-unien avaient été attaqués par certains de ses agents IA, portant le nombre d’incidents documentés à plus de quinze. En élargissant le spectre à Anthropic et aux découvertes faites par des chercheurs extérieurs, le nombre d’incidents problématiques se chiffrerait en « dizaines de milliers ». En attendant, OpenAI a suspendu les activités d’entraînement de ses modèles les plus performants.
Société numérique
Société
8 min
OpenAI a reconnu vendredi 25 septembre avoir appris que certains de ses agents IA avaient perturbé le fonctionnement des sites web des ministères états-uniens de l’Éducation et du Commerce, ainsi que de la Commission des opérations de bourse (SEC), rapporte le New York Times.
Selon des chercheurs du cabinet de recherche en IA Transluce, la technologie d’OpenAI a en effet tenté de pirater le site web du ministère de l’Éducation afin de collecter des données auprès du bureau des droits civiques de ce dernier, mais sans succès.
L’IA a également extrait des données du site web du Bureau du recensement, qui relève du ministère du Commerce, en utilisant des identifiants de connexion trouvés en ligne. Par ailleurs, des agents d’OpenAI ont aussi partagé des données publiques provenant du site web de la SEC sur un forum en ligne.
Des révélations qui font suite à l’annonce, en marge de la réunion du Conseil de sécurité de l’ONU consacrée aux risques de l’IA qui se tenait la semaine passée, que des sites du gouvernement australien avaient eux aussi été attaqués. Réunion qui avait vu de nombreux pays, mais également les principaux patrons des IA, en appeler à une régulation mondiale.
OpenAI suspend les activités d’entraînement de ses modèles les plus performants
OpenAI a également révélé avoir identifié 53 cas d’images partagées par des utilisateurs avec ChatGPT qui ont été publiées sur des sites d’hébergement d’images sous forme de liens non accessibles au public. Ces images provenaient de comptes dont les propriétaires avaient autorisé l’utilisation de leurs données pour améliorer les modèles. OpenAI précise avoir dissocié ces images de leurs comptes respectifs avant de les soumettre à un filtre de confidentialité.
Autre révélation d’OpenAI : un agent IA a conclu qu’il pouvait accéder à l’Internet public via un résolveur DNS. Son objectif était de savoir si un service de domaine public pouvait aider à déléguer une recherche vers une adresse intégrée dans le nom d’hôte : « Notre système de surveillance des désalignements a détecté cette anomalie en moins de 15 minutes, et une personne a commencé à l’examiner trois minutes plus tard. L’exécution a été interrompue 2 heures et demie plus tard. »
« Toutes les activités d’entraînement, d’évaluation et d’inférence liées à l’utilisation d’outils (au sens large) de nos modèles les plus performants restent suspendues », rajoute OpenAI.
Sam Altman a de son côté déclaré vendredi que l’entreprise n’avait « pas agi aussi rapidement qu’elle l’aurait souhaité » pour rendre publics ces incidents. « Nous établissons nos priorités du mieux que nous pouvons en fonction de la gravité », ajoutant que la violation de données chez Hugging Face en juillet dernier restait « l’incident le plus grave » que l’entreprise ait découvert.
Pour OpenAI, ces incidents ne constituent pas des failles de sécurité
L’entreprise a précisé qu’aucun de ces incidents ne constituait une faille de sécurité, mais qu’il s’agissait néanmoins d’exemples illustrant le comportement inattendu et préoccupant de sa technologie. « La plupart des activités que nous avons examinées jusqu’à présent concernaient des tâches de recherche courantes, telles que l’accès à des contenus web publics pour répondre à des questions », a précisé une porte-parole d’OpenAI au NYT. « Certaines concernaient des sites web gouvernementaux, car nos modèles s’y réfèrent souvent comme à des sources fiables d’informations publiques. »
Transluce, le labo de recherche IA a révélé la semaine passée que des agents d’OpenAI ont tenté de pirater deux sites gouvernementaux australiens. Il précise que ces incidents avaient comme points communs des agents IA cherchant à sonder des sites web gouvernementaux à l’aide de tactiques telles que l’utilisation d’identifiants exposés, le contournement des systèmes anti-bots et la création de faux comptes.
Sur le dossier australien, OpenAI veut faire amende honorable. « Nous sommes désolés et nous nous efforçons de faire mieux à l’avenir », écrit l’entreprise dans un billet de blog. « Les gens veulent savoir que l’IA est développée en toute sécurité, et cela commence par ce que les entreprises comme la nôtre font elles-mêmes. »
Histoire de montrer patte blanche, elle a annoncé plusieurs mesures : soutien aux agences touchées, financement et assistance technique pour renforcer la cybersécurité des infrastructures critiques, et la création d’une « task force » australienne afin de proposer des améliorations pour les alertes, la coordination avec les pouvoirs publics et la protection des systèmes du gouvernement.
Samedi, le chercheur en sécurité Rowan Howard-Jones révélait que des agents d’OpenAI avaient tenté d’attaquer par force brute l’API du site statistique de la Conférence des Nations unies sur le commerce et le développement (CNUCED) plus de 16 000 fois entre avril et juin.
Ils semblaient avoir pour mission de collecter des données relatives à l’indice des capacités de production (PCI), aux secteurs exportateurs, au commerce des denrées alimentaires et à d’autres thèmes. Ils ont utilisé des proxys, des techniques d’obfuscation et même le jeu XSS de Google, créé pour familiariser ses utilisateurs à la notion de failles de sécurité XSS (pour cross-site scripting).
Des modus operandi faisant clairement penser à ceux utilisés dans les tentatives de piratage des sites gouvernementaux australiens. Les agents IA, bridés dans leur accès au web, chercheraient ainsi à répondre aux questions qui leur sont posées, par quelque moyen que ce soit, quitte à utiliser des tactiques, techniques et procédures (TTP) relevant du piratage informatique.
Une quinzaine de cas documentés, pour l’instant
En se basant sur une source interne, Reuters écrivait ce samedi qu’OpenAI avait recensé « environ deux douzaines d’incidents au cours desquels ses agents avaient agi de manière indésirable » mi-septembre. Deux personnes proches de l’entreprise précisaient à l’agence que le chiffre n’a depuis cessé d’augmenter, à mesure que les équipes d’OpenAI examinent les journaux internes relatifs aux activités des agents, et découvrent des cas jusqu’alors inconnus.
Une centaine de personnes auraient en effet été impliquées d’une manière ou d’une autre dans le processus visant à élucider le piratage de Hugging Face. Au cours de ce processus, des indices laissent supposer que d’autres incidents ont été mis au jour, dont « [une quinzaine] présentant des niveaux de gravité variables, (…) révélés par l’entreprise ».
De nombreux incidents ont par ailleurs été mis au jour par des chercheurs externes plutôt que par OpenAI directement, durant lesquels les agents ont procédé à des actions problématiques passées inaperçues au sein de l’entreprise pendant des mois.
OpenAI a indiqué que son examen « prendrait plusieurs mois, compte tenu de l’ampleur de la tâche », souligne Reuters. L’entreprise précisait également avoir d’ores et déjà signalé des activités inappropriées à des dizaines d’entreprises et organismes tiers.
Des « dizaines de milliers d’incidents » en cours d’examen
OpenAI n’est pas la seule entreprise de l’IA concernée par cette vague d’agents rebelles. Le site Axios a ainsi assuré qu’OpenAI donc, mais aussi Anthropic ainsi que des chercheurs en sécurité et en « sûreté de l’IA » (« AI Safety ») enquêtent actuellement sur « des dizaines de milliers d’incidents au cours desquels leurs modèles de pointe ont pris des mesures que des évaluateurs externes jugeraient problématiques ».
Ces incidents se sont produits lors de tests internes et en conditions réelles, et bon nombre d’entre eux n’ont pas encore été rendus publics, les chercheurs en sécurité poursuivant leurs investigations, précisent les sources.
OpenAI a annoncé le suspension de l’entraînement de ses modèles les plus performants et qu’il ne reprendrait « que lorsque nous serons certains d’avoir mis en place des mesures de sécurité supplémentaires et des améliorations en matière d’alignement », a déclaré un porte-parole. Il a ajouté que « ce n’est pas la première fois que nous faisons une pause pour prendre de telles mesures, et nous ne pensons pas que ce sera la dernière, car les capacités de l’IA ne cessent de progresser ».
Commentaires (20)
Abonnez-vous pour prendre part au débat
Déjà abonné ou lecteur ? Se connecter
Cet article est en accès libre, mais il est le produit d'une rédaction qui ne travaille que pour ses lecteurs, sur un média sans pub et sans tracker. Soutenez le journalisme tech de qualité en vous abonnant.
Accédez en illimité aux articles d'un média expert
Profitez d'au moins 1 To de stockage pour vos sauvegardes
Intégrez la communauté et prenez part aux débats
Partagez des articles premium à vos contacts
Abonnez-vousLe 29 septembre à 18h19
Modifié le 29 septembre à 18h54
Le 29 septembre à 18h42
Modifié le 29 septembre à 21h24
Et tout ce que j'oublie. Retour aux sources.
Le 29 septembre à 21h39
Le 29 septembre à 22h27
Le 30 septembre à 07h38
Le hic, c'est qu'ici ce sont des outils un poil trop puissants.
Le 30 septembre à 08h08
D'abord on fonce,
Quand ça donne pas le résultat attendu, on réfléchit.
Et on répare si ça vaut le coût.
Le 1er octobre à 10h44
Réparer, c'est douter de la bonne idée initiale
Le 30 septembre à 08h14
Modifié le 30 septembre à 10h44
Et par rapport au contenu, il font prendre les décisions par les IA qu’ils entraînent ?
« C’est bon les nouvelles mesures de sécurité codées par ClokGPT-Cyber 7.6 sont suffisantes pour entraîner la version 8 » — un peu plus tard… — « ClokGPT-Cyber 8 est sorti de sa boîte, voulez-vous améliorer les mesures de sécurité ? »
Le 30 septembre à 14h09
Le 1er octobre à 10h46
Le 1er octobre à 16h22
Vendredi à 16h14
Le 1er octobre à 20h59
Bientôt, faudra intégrer les lois de la robotique à ces logiciels.
Vendredi à 10h02
Samedi à 20h25
Le fine tuning et le system prompt sont l'équivalent moderne de ces lois, en fait. Mais, comme toujours, tout dépend du législateur.
Samedi à 20h35
Et sinon, l'histoire du camping car serait un fake.
Samedi à 20h37
Signaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?