SpaceXAI lance son modèle Grok 4.7, dont les performances déçoivent
Overhyped

SpaceXAI a lancé son nouveau modèle Grok 4.7 ce 21 septembre. Si Elon Musk vantait l’arrivée de cette version, les résultats indépendants ne semblent pas à la hauteur des attentes. En revanche, le LLM garde pour lui l’avantage d’une tarification plus douce que certains des gros modèles lancés ces derniers mois.
La version 4.7 de Grok repose sur un nouveau modèle de base, plus grand que pour Grok 4.6. Dans son annonce, SpaceXAI indique qu’il a été entraîné par renforcement plus longtemps, sur des tâches plus difficiles, avec un accent sur les problèmes qui demandent plusieurs heures de travail. L’entreprise affirme que le modèle vérifie mieux son propre travail et gère mieux les contextes longs. Le modèle a aussi été entraîné pour fonctionner nativement dans l’environnement Grok Bot.
Dans la documentation fournie, on peut lire que le modèle grok-4.7 dispose d’une fenêtre de 500 000 jetons (tokens), ses connaissances s’arrêtant en mai 2026. Sans surprise, le LLM est multimodal (texte et images en entrée) et produit du texte en sortie. On retrouve en outre les quatre mêmes niveaux de raisonnement : bas, moyen, haut (par défaut) ou très haut (xhigh). Appel de fonctions, recherche web ou sur X, ou encore exécution de code sont autant de possibilités mises en avant par SpaceXAI.
La société d’Elon Musk met en avant de nombreuses qualités en phase avec les discussions actuelles autour de la sécurité. Elle évoque par exemple « de solides capacités de défense cyber » tout en gardant « de faibles taux de refus d’utilisation légitime ». Grok 4.7 aurait obtenu le score le plus élevé sur HackberBench 0.3 et n’aurait autorisé que 3,3 % des prompts risqués. En outre, le nouveau LLM se montrerait plus robuste face aux tentatives de jailbreak.
Des performances en deçà des attentes
Sur le chapitre des performances, la situation est plus complexe. Selon les chiffres avancés par l’entreprise, Grok 4.7 se débrouille bien sûr très bien. Cependant, on remarque vite que le tableau donné par SpaceXAI ne compare pas toujours les mêmes éléments. Par exemple, Grok 4.7 est testé en mode de raisonnement xHigh alors que Grok 4.6 est testé en High.
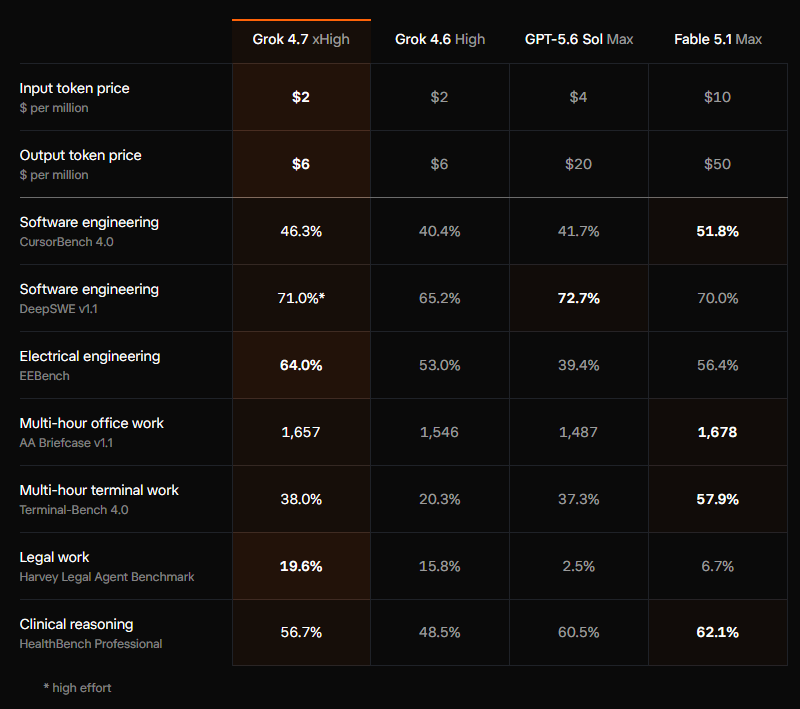
Cela n’empêche pas l’entreprise de revendiquer de très bonnes performances, surtout face à son modèle précédent et dans des domaines particuliers. « Grok 4.7 est meilleur pour créer des documents et des présentations. Dans GDPval et AA Briefcase, l’IA est sollicitée pour travailler sur des tâches réalisées par des professionnels tels que des avocats, des infirmiers et des analystes financiers. Grok 4.7 améliore Grok 4.6 sur les deux benchmarks et se comporte de manière comparable à d’autres modèles Frontier », affirme ainsi SpaceXAI.
Sur X, on trouve déjà de nombreux commentaires et tests réalisés, plus ou moins spécifiques. Côté positif, on note par exemple le tweet d’Auggie qui relève un taux de 100 % sur son test de « détection d’erreurs » sur la musique, un score que seul avait atteint Astra. Le même testeur a en revanche été moins enthousiasmé sur Bach Benchmark (qui demande aux LLM de composer des chorals à quatre voix dans le style de Bach). Si l’on en croit Artificial Analysis, les revendications de SpaceXAI sur la création de documents sont avérées, avec en particulier un bond significatif sur le test Analytical Quality Elo.
Toutefois, les retours négatifs sont plus nombreux. Pour Jose Antonio Lanz par exemple, Grok 4.7 n’a rien d’un mauvais modèle, mais il est derrière la concurrence, particulièrement Astra ou même Sonnet 5 selon les essais réalisés. Il souligne d’ailleurs qu’Elon Musk avait lui-même cherché à diminuer les attentes autour de son modèle, en indiquant dans un tweet le 14 septembre que Grok 4.7 serait davantage à comparer à Open 5 que 5.1. Il en profite pour annoncer que Grok 4.8 sera une « amélioration notable », que Grok 4.9 sera « probablement » au niveau d’Astra et Fable et que Grok 5 sera « peut-être meilleur que tout le reste ». Plusieurs personnes ont alors fait remarquer qu’OpenAI et Anthropic allaient eux aussi lancer de nouveaux modèles pendant ces laps de temps.
Selon The Decoder, Grok 4.7 obtient 46 à l’indice Artificial Analysis (v4.3.2), qui agrège dix tests. Il se place ainsi en milieu de peloton, derrière Claude Fable 5.1 et GPT-6, à 53 chacun. Sur Terminal-Bench 4.0, l’évaluation donne 26 %, bien en dessous des 38 % annoncés par xAI, et très loin des 60 % atteints par Astra et des 55 % de Fable 5.1.
L’argument du prix
Si les performances semblent globalement décevantes, Grok 4.7 se débrouille mieux que son prédécesseur dans la quasi-totalité des scénarios, sans toucher aux prix. On reste donc sur 2 dollars par million de jetons en entrée et 6 dollars par million en sortie. Une variante Fast est disponible, servie par une infrastructure plus rapide, avec une facturation doublée. Elle n’est cependant disponible que via Cursor et Grok Build, pas sur l’API publique. Sur cette dernière, tous les cas d’usage passant par Grok 4.6 ont automatiquement basculé sur le nouveau modèle.
SpaceXAI joue d’ailleurs la carte du rapport performances/prix en comparant sa grille tarifaire à celles de concurrents. GPT-5.6 Sol et Claude Fable 5.1 sont dans la ligne de mire, avec respectivement 4/20 dollars et 10/50 dollars.
Le positionnement général est ainsi celui d’un modèle faisant mieux que Grok 4.6, disponible au même prix et plus léger sur la facturation que des modèles plus puissants. Il n’y a donc pas de rupture, et on reste sur l’interrogation classique du choix du modèle en fonction du scénario d’usage envisagé.
Enfin, on notera que le calendrier des sorties des prochaines versions ne semble pas ralentir, puisque Grok 4.8 serait proposé dans un mois. Une affirmation à prendre avec des pincettes, Grok 4.7 ayant été repoussé plusieurs fois. Le rythme cadre mal cependant avec le positionnement d’Elon Musk sur la nécessité de ralentir le développement des modèles de frontière. Il a publiquement soutenu l’idée de Dario Amodei, CEO d’Anthropic, de calmer le jeu et de réfléchir à un cadre clair pour mesurer l’alignement des modèles. Comme nous l’avions relevé toutefois, ces déclarations d’intentions ne semblent pas suivies d’actions concrètes.

Commentaires (0)
Abonnez-vous pour prendre part au débat
Déjà abonné ou lecteur ? Se connecter
Cet article est en accès libre, mais il est le produit d'une rédaction qui ne travaille que pour ses lecteurs, sur un média sans pub et sans tracker. Soutenez le journalisme tech de qualité en vous abonnant.
Accédez en illimité aux articles d'un média expert
Profitez d'au moins 1 To de stockage pour vos sauvegardes
Intégrez la communauté et prenez part aux débats
Partagez des articles premium à vos contacts
Abonnez-vousSignaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?