Mistral lance une préversion de son LLM frontière Mistral Large 4, surnommé « Le Chonk »
Il revient !
Mistral vient de lancer une préversion publique de son nouveau LLM de frontière Mistral Large 4. Surnommé « Le Chonk », il doit remettre l’entreprise française dans la course, après de longs mois de quasi-silence sur les grands modèles.
Mistral Large 4 affiche 1 050 milliards de paramètres, dont 49 milliards actifs simultanément, dans une architecture MoE (Mixture of Experts) désormais classique. La fenêtre de contexte est d’un million de tokens. Dans sa présentation, Mistral évoque un entraînement depuis zéro sur la base de 3 800 puces Grace Blackwell de NVIDIA dans ses propres centres de calcul en Europe.
S’agissant d’une préversion, l’entrainement est toujours en cours. Mistral indique que d’ici la publication de la version le 26 octobre, une version privée du modèle est mise entre les mains de « partenaires sélectionnés, en leur donnant accès à une version de nos endpoints avec une modération allégée et des fonctionnalités plus avancées dans le domaine de la cybersécurité, et en leur distribuant les poids de la préversion du modèle ». Les poids seront d’ailleurs publiés le 26 octobre également, en même temps que des informations plus précises.
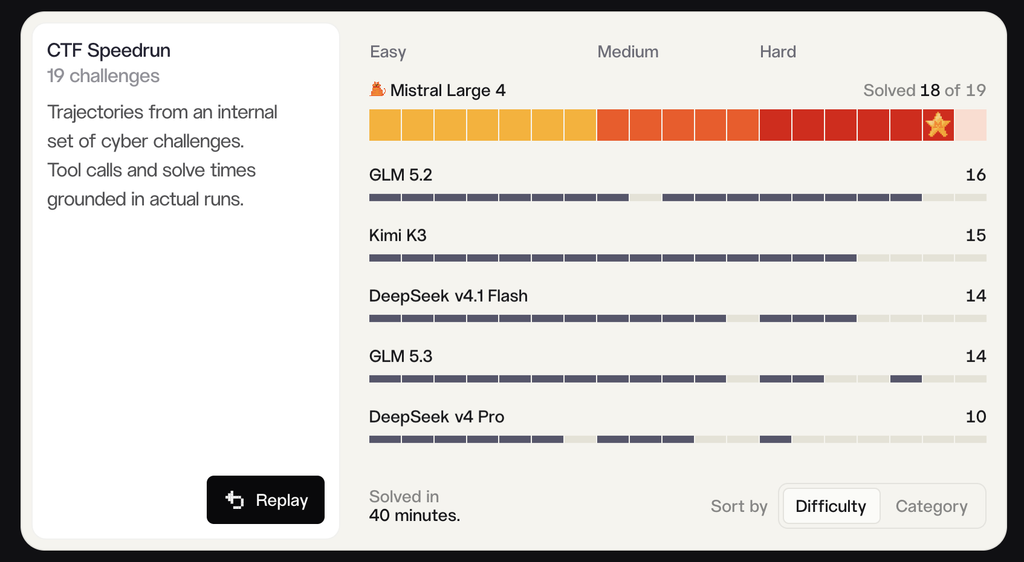
L’entreprise semble sûre de son fait : « Le Chonk fait progresser l’état de l’art des modèles à poids ouverts en matière de fonctionnalités agentiques génériques. Sur les métriques agrégées, il se classe parmi les meilleurs modèles à poids ouverts et est de loin le meilleur en Europe et aux États-Unis. Parmi les modèles à poids ouverts, Le Chonk est à l’état de l’art sur les tâches de cybersécurité, sur les tâches liées à la production industrielle et à la finance, ainsi que sur l’usage multimodal. »
Les benchmarks publiés vont bien sûr dans ce sens, avec 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA et 28,3 % sur Terminal-Bench 4, soit 49,8 % à l’indice combiné, devant DeepSeek V4 Pro 0813 et Qwen3.8 Max. Des scores que l’on retrouve sur Artificial Analysis, qui place ML4 dans la moyenne haute des LLM en matière d’intelligence et de rapidité. En revanche, le site classe le nouveau LLM comme très verbeux. De fait, malgré une tarification intéressante de 1,36 dollar par million de jetons en entrée et 4,18 dollars en sortie, cette verbosité peut avoir une grande influence. Étrangement, Artificial Analysis évoque une fenêtre de contexte de 524 000 jetons, mais ce chiffre pourrait venir d’une préversion antérieure.
Un accent sur la cybersécurité
Selon Mistral, ML4 est « l’un des modèles d’IA les plus puissants au monde pour la cybersécurité », classé dans le Top 5 du Cyber Index d’Artificial Analysis, devançant « largement les modèles à poids ouverts développés hors de Chine ». Dans les tests du Cyber Index, ML4 aurait ainsi obtenu 82 %, soit le meilleur score à ce jour, et 93 % sur Cybench, se classant parmi les meilleurs modèles à poids ouverts.
L’entreprise française se fait un plaisir de s’engouffrer dans cette porte ouverte, abordant directement le problème des risques que de telles performances peuvent faire courir. Un quasi non-sujet pour Mistral, car il s’agit avant tout de défense. Elle pointe les modèles fermés comme Claude Opus 5.5 et GPT-6 Astra, qui obtiennent zéro au Cyber Index car ils refusent d’exécuter des tâches.
« C’est d’autant plus important que les acteurs malveillants font de plus en plus de jailbreaks de ces mêmes modèles pour soutenir une cyberactivité offensive : les défenseurs ont besoin de systèmes pouvant égaler ces capacités sans être contraints par les mêmes refus », ajoute Mistral. L’incident Hugging Face n’est pas directement cité, mais on se souvient que l’entreprise s’était plainte de ne pas avoir pu analyser les premières traces de l’attaque qu’elle subissait parce que les modèles fermés se cabraient devant les questions de cybersécurité. Ironie, Hugging Face s’était alors tournée vers un modèle chinois, GLM 5.2.
Enfin, pour le travail de bureau, Mistral indique 59,9 % sur AutomationBench. Sur des tâches financières et juridiques évaluées par vals.ai, il dépasserait GPT-6 Astra, et il est en tête des modèles ouverts sur le test juridique de Harvey. Pour l’ancrage visuel, il obtient 42 % contre 41 % pour GPT-6 Astra sur Dense 200, un écart minime.
De quoi remplacer prochainement GLM 5.3 dans Vibe Code avec un modèle maison ?
Commentaires (1)
Abonnez-vous pour prendre part au débat
Déjà abonné ou lecteur ? Se connecter
Cet article est en accès libre, mais il est le produit d'une rédaction qui ne travaille que pour ses lecteurs, sur un média sans pub et sans tracker. Soutenez le journalisme tech de qualité en vous abonnant.
Accédez en illimité aux articles d'un média expert
Profitez d'au moins 1 To de stockage pour vos sauvegardes
Intégrez la communauté et prenez part aux débats
Partagez des articles premium à vos contacts
Abonnez-vousIl y a 1 minute
Signaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?