« Un vol d’une ampleur sans précédent » : les documents qui fragilisent OpenAI
« Boucle infernale »

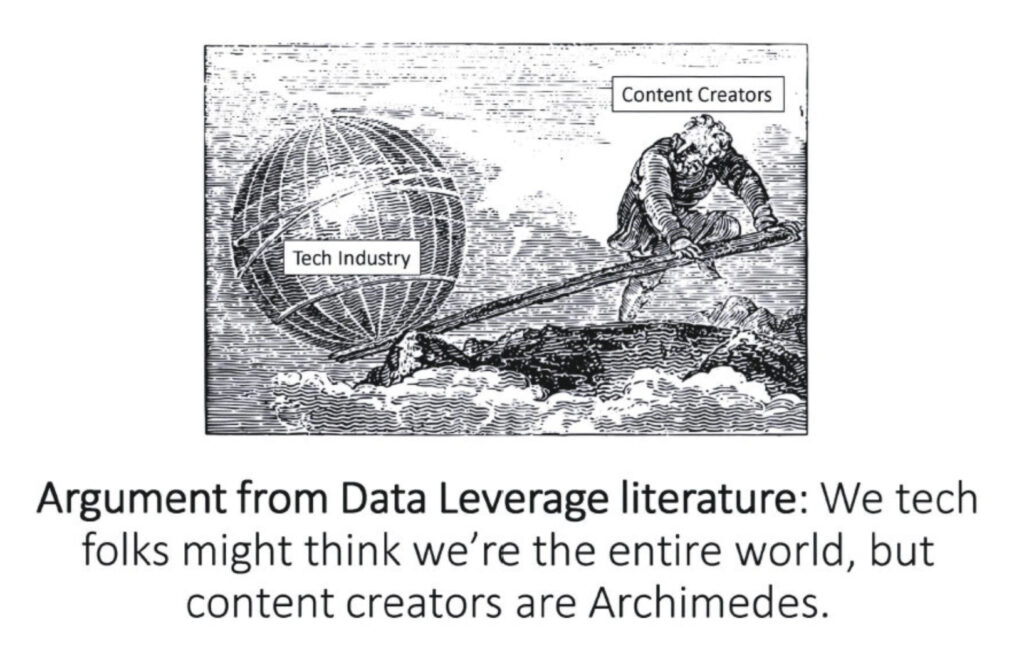
« Le plus grand vol de travail de l’histoire de l’humanité » : cette déclaration reprise par le New York Times dans sa procédure en justice contre OpenAI résonne particulièrement fort puisqu’elle émane de Brent Hecht, directeur scientifique de Microsoft. Dans un mémoire de synthèse remis à la justice, l’éditeur du célèbre quotidien aligne les éléments à charge contre le créateur de ChatGPT.
Le New York Times est parti en guerre contre OpenAI. En décembre 2023, l’éditeur portait plainte contre l’entreprise IA, l’accusant d’avoir utilisé des millions d’articles sans autorisation pour entraîner ses modèles GPT. L’administration Trump a récemment volé au secours d’OpenAI, en affirmant que l’entraînement de l’IA sur des contenus protégés par droit d’auteur relevait du « fair use » (usage équitable), un argument seriné en boucle par les entreprises IA pour se défausser de leur responsabilité.
Des documents internes difficiles à balayer
Le mémoire de synthèse, déposé devant le tribunal fédéral de New York (PDF) par le NYT et d’autres éditeurs de presse (Chicago Tribune, Ziff Davis, Mother Jones…), détaille les éléments recueillis pendant la phase de collecte des preuves : témoignages sous serment, messages et autres documents produits par OpenAI et Microsoft. Ils sont évidemment à charge, mais ils s’appuient sur des pièces et des témoignages qui donnent un aperçu assez cru de la manière dont OpenAI et Microsoft considéraient en interne l’exploitation des contenus de presse.
Le témoignage de Brent Hecht est particulièrement embarrassant. Selon lui, « des millions de personnes dans le monde considéreront bientôt que les grands modèles qui « aspirent » tout leur travail constituent un vol d’une ampleur sans précédent ». Il admet que « presque personne n’avait prévu que les contenus créés seraient utilisés de cette manière, sans que leurs auteurs soient rémunérés ».
Le directeur scientifique de Microsoft estime aussi qu’accepter l’argument d’OpenAI selon lequel le moissonnage de contenus n’est que du « fair use » revient à complètement vider la notion de son sens. « Ces propos reflètent le point de vue personnel d’un employé et ne constituent pas une analyse juridique », a déclaré Microsoft auprès d’Ars Technica.
Le mémoire cite un autre échange dans lequel Nick Ryder, responsable de recherche chez OpenAI, annonce à Greg Brockman l’existence d’un « moyen pour contourner le paywall du New York Times » afin de collecter les articles. Le cofondateur et président de l’entreprise a simplement répondu : « ah, très bien » (« ah nice »).
Des aveux qui tombent mal
Les éditeurs de presse font tout simplement face à une « menace existentielle », reconnait Nick Turley, responsable de ChatGPT chez OpenAI, dans un message interne remontant à juin 2023. Une fois que ChatGPT fournit une réponse, il n’y a « aucune bonne raison de cliquer » sur le lien vers la source d’origine, ajoute-t-il. Un document chez Microsoft parle de « boucle infernale » : en détournant une partie du trafic des sites d’actualité, les assistants IA fragilisent les éditeurs qui produisent précisément les contenus dont leurs modèles ont besoin pour rester performants.
Selon les propres données de Microsoft, le taux de clic depuis Bing Chat ou Copilot vers les sites des éditeurs est très inférieur à celui observé depuis la recherche Bing classique : baisse de 87 à 93 % pour les sites du New York Times, de 83 à 91 % pour les autres plaignants. C’est d’autant moins de revenus pour les sites de presse qui se retrouvent en concurrence avec leurs propres contenus recrachés par les bots. Un ingénieur logiciel d’OpenAI reconnaissait dans un message interne que, « peu importe la visibilité donnée aux liens, les utilisateurs ne cliqueront pas dessus ».
Satya Nadella face à la question des paywalls
Dans son témoignage sous serment, Satya Nadella, le directeur général de Microsoft, admet que « tout contenu placé derrière un paywall devrait faire l’objet d’une licence de la part de quiconque souhaite l’utiliser, que ce soit pour alimenter les réponses d’un modèle ou pour son entraînement ».
S’il avait su qu’OpenAI – dont Microsoft est un des principaux partenaires – avait moissonné des contenus placés derrière un paywall pour entraîner ses modèles IA, Nadella aurait invoqué le droit de Microsoft d’exiger le réentraînement des modèles sans ces données protégées. Pour le dirigeant, les entreprises IA ne devraient pas accéder à des contenus enfreignant les conditions d’utilisation.
Satya Nadella reconnait également que les chatbots comme Copilot peuvent se substituer aux sites d’actualité : ils donnent en effet l’information « directement sur la plateforme d’IA, plutôt que d’obliger l’utilisateur à se rendre à la source d’origine ». Pour le porte-parole de Microsoft, ce témoignage porte sur des « principes généraux », il ne s’agit que « d’observations qui ne doivent pas être confondues avec des conclusions sur les questions de droit d’auteur soumises au tribunal ».
Si ce mémoire de synthèse est certes accablant, il ne constitue pas pour autant une décision de justice ni une conclusion du tribunal sur le fond de l’affaire. Néanmoins, les pièces de première main qu’il expose éclairent l’état d’esprit d’OpenAI et de Microsoft quant à la portée réelle de leur utilisation du « fair use ».

Commentaires (0)
Abonnez-vous pour prendre part au débat
Déjà abonné ou lecteur ? Se connecter
Cet article est en accès libre, mais il est le produit d'une rédaction qui ne travaille que pour ses lecteurs, sur un média sans pub et sans tracker. Soutenez le journalisme tech de qualité en vous abonnant.
Accédez en illimité aux articles d'un média expert
Profitez d'au moins 1 To de stockage pour vos sauvegardes
Intégrez la communauté et prenez part aux débats
Partagez des articles premium à vos contacts
Abonnez-vousSignaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?