IA : le nouveau modèle Jev se veut le champion des « décisions typées »
Ceci n'est pas un LLM

La société TypeSafe AI a présenté il y a quelques jours un nouveau modèle d’IA. Baptisé Jev, il se propose de traiter certaines opérations bien plus rapidement que les LLM « traditionnels », pour beaucoup moins cher. La comparaison reste cependant délicate.
L’annonce a fait l’effet d’une petite bombe sur les réseaux sociaux, particulièrement sur X : la société TypeSafe AI, fondée par Diogo Almeida, a annoncé son nouveau modèle de frontière, Jev.
Diogo Almeida se présente comme co-inventeur de ChatGPT. Un titre un peu exagéré. Il a travaillé effectivement sur les méthodes qui ont rendu capables les modèles GPT de suivre des instructions et de converser avec les utilisateurs. Mais il serait plus juste de dire qu’il est le co-inventeur du RLHF (Reinforcement Learning from Human Feedback), c’est-à-dire l’apprentissage par renforcement à partir de rétroaction humaine. Il est effectivement l’un des auteurs d’un papier fondateur sur la question.
Jev, en tout cas, n’est pas un LLM : il ne peut pas créer de texte ni même aider à la programmation. Il est décrit comme le premier « System One Model », une nouvelle catégorie de modèles conçus pour prendre des décisions rapides et structurées, que des services ou applications peuvent ensuite utiliser directement.
Ce qu’est Jev
Le modèle est comparé par TypeSafe AI à un appel de fonction : un état non structuré en entrée, des décisions probabilistes typées en sortie. Concrètement, on lui envoie un état (le contexte) et des questions portant sur cet état. Les réponses possibles sont fixées à l’avance par un schéma. Jev répond ensuite via trois primitives : le choix d’une option dans un ensemble, une note sur une échelle ordonnée, et un oui ou non calibré.
Pour bâtir Jev, TypeSafe AI dit avoir construit une nouvelle architecture de modèle, un échantillonneur parallèle et une nouvelle méthode de renforcement baptisée RLCD, pour « Reinforcement Learning for Calibrated Decisions ». L’échantillonneur parallèle signifie que toutes les questions d’une requête sont évaluées en parallèle, contrairement à un LLM dont chaque nouvel élément dépend du précédent.
Plusieurs points forts sont mis en avant, notamment la calibration via RLCD. Selon l’entreprise, cet entrainement doit permettre des réponses assorties de probabilités « honnêtes ». Dans ce contexte, une confiance plus élevée (donnée sous forme de pourcentage) signifie une meilleure exactitude. En outre, TypeSafe affirme que Jev ne peut pas halluciner, puisque la sortie est contrainte par le schéma. Il faut cependant lire entre les lignes : dans ce contexte, Jev garantit le respect du format, pas la justesse du format. En d’autres termes, Jev ne peut rien « inventer », mais il peut se tromper de catégorie.
Vite, un exemple !
Pour mieux comprendre l’intérêt de ce nouveau modèle, mieux vaut un exemple. Imaginons un service client qui reçoit 10 000 e-mails par jour. Pour chacun, un programme doit prendre plusieurs décisions : le client est-il mécontent ? Faut-il envoyer le message au service facturation, technique ou commercial ? Est-ce urgent ?
Aujourd’hui, ce type de tâche est souvent confié à un LLM comme GPT ou Claude. On lui envoie l’e-mail avec une consigne du type « dis-moi si c’est urgent », et il répond par une phrase : « Oui, ce message semble urgent car le client menace de résilier ». Problème, un programme informatique ne « comprend » pas les phrases. Il faut donc un travail supplémentaire pour extraire le « oui » de cette phrase. De plus, le modèle peut répondre à côté, ajouter des commentaires inutiles ou inventer une catégorie qui n’existe pas. Enfin, écrire une phrase mot par mot prend du temps et coûte cher.
Jev ne fonctionne pas avec des phrases, mais avec trois primitives. On applique une liste de questions dont les réponses sont fixées à l’avance :
- Le client est-il mécontent ? Oui/Non
- Quel service doit traiter cet e-mail ? Facturation/Technique/Commercial
- Quelle urgence sur une note de 1 à 5 ?
Si on continue dans cet exemple, on obtiendra une réponse du type : « oui (92 % de certitude), facturation (85 %), urgence 4 (70 %) ». Cela revient à donner un formulaire à remplir pour répondre à une question plutôt que demander son avis à une personne.
Les données émises par Jev sont formatées et peuvent être reprises telles quelles par d’autres éléments de traitement de la chaine. Quand TypeSafe affirme que son modèle ne peut pas halluciner, cela signifie que Jev ne peut pas répondre par exemple « Juridique » pour le service à contacter. En revanche, rien ne l’empêche de se tromper sur le service à effectivement contacter. On peut alors appliquer un filtre pour automatiser l’envoi à une équipe humaine pour toutes les réponses dont le score de confiance est inférieur à 80 %.
L’efficacité mise en avant
L’un des éléments les plus repris par la presse est l’efficacité du modèle. Sur les tâches pour lesquelles il a été pensé, le temps de réponse annoncé va de 70 à 500 ms, soit 40 à 200 fois plus rapide que les modèles de pointe pour des requêtes de ce type. Le prix est de 0,042 dollar par million de jetons en entrée, et la sortie est gratuite. À titre de comparaison, GPT-5.6 Terra coûte 2 dollars par million de jetons en entrée et 12 dollars en sortie.
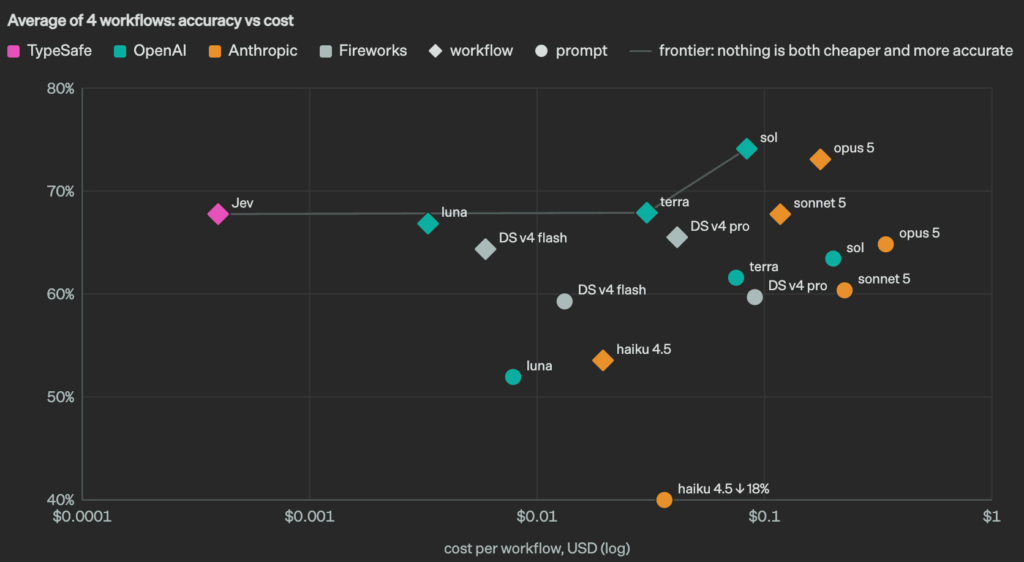
Dans sa présentation, TypeSafe donne des chiffres mais émet elle-même des réserves. Ainsi, les gains maximaux peuvent être très précisément de x193,6 sur les performances et x444,6 moins cher. Ces chiffres viennent de quatre chaines de traitement interne : réponse aux incidents de sécurité, observation de traces d’agents, traitement de factures et service client.
Même si TypeSafe évoque une certaine prudence, il est difficile pour l’instant de jauger des performances réelles comme de la facture finale, car le modèle n’est disponible pour tout le monde que depuis le 20 septembre, sans liste d’attente. Si l’on en croit certains retours d’entreprises ayant testé le modèle, le gain semble avéré.
En outre, l’annonce de Jev est déjà contestée. Selon Nandakishor Mukkunnoth, fondateur de ConvAI Innovations, l’idée n’est pas nouvelle. Dans un billet, il indique être à l’origine des recherches qui ont mené à cette technique, dont il revendique la paternité. Il ne reproche pas à TypeSafe d’avoir copié du code, mais de ne pas avoir cité des travaux antérieurs. Sur Hacker News, plusieurs personnes notent que ce type de mésaventure est malheureusement courant, mais que l’apport de TypeSafe est surtout d’avoir réussi à en faire un produit concret.
Ce qui n’a pas empêché Nandakishor Mukkunnoth de publier une alternative libre, nommée Laya. D’autres modèles libres sont apparus en quelques jours. Si l’on en croit les premiers tests réalisés indépendamment, tous les modèles affichent des performances moindres que Jev. Si l’on donne un score de référence de 1 à ce dernier, les 78 tests effectués font ressortir des notes alternant entre 0,5 et 0,7, Laya étant dans la moyenne.

Commentaires (1)
Abonnez-vous pour prendre part au débat
Déjà abonné ou lecteur ? Se connecter
Cet article est en accès libre, mais il est le produit d'une rédaction qui ne travaille que pour ses lecteurs, sur un média sans pub et sans tracker. Soutenez le journalisme tech de qualité en vous abonnant.
Accédez en illimité aux articles d'un média expert
Profitez d'au moins 1 To de stockage pour vos sauvegardes
Intégrez la communauté et prenez part aux débats
Partagez des articles premium à vos contacts
Abonnez-vousÀ l'instant
c'est sympa pour de la prise de décision réactive, en fait c'est juste la suite des modèle en apprentissage par renforcement qui ont besoin d'infos sur l’environnement, et qui a des actions à dispo, et un algo de récompense pilote les enchainement d'actions. ça semble bien marcher;)
Signaler un commentaire
Voulez-vous vraiment signaler ce commentaire ?